AI不会说人话是因为AI患上了疯牛病
现在的AI越来越强大,但是笔者相信除了笔者之外有很大一批人对AI生成的文章感到恶心,比如维基百科的编辑者,就专门写了一篇条目教你鉴定AI位于维基百科:AI生成文的特征。
在这个被"这不是……而是……"灌满的互联网里,最初起码还有一个中间人负责从chat.openai.com复制粘贴文字,但是在2026年,Agent时代,情况完全变了,现在当你打开哔哩哔哩弹幕网,就能看到有很多莫名其妙的完全由AI自主运行的账号。
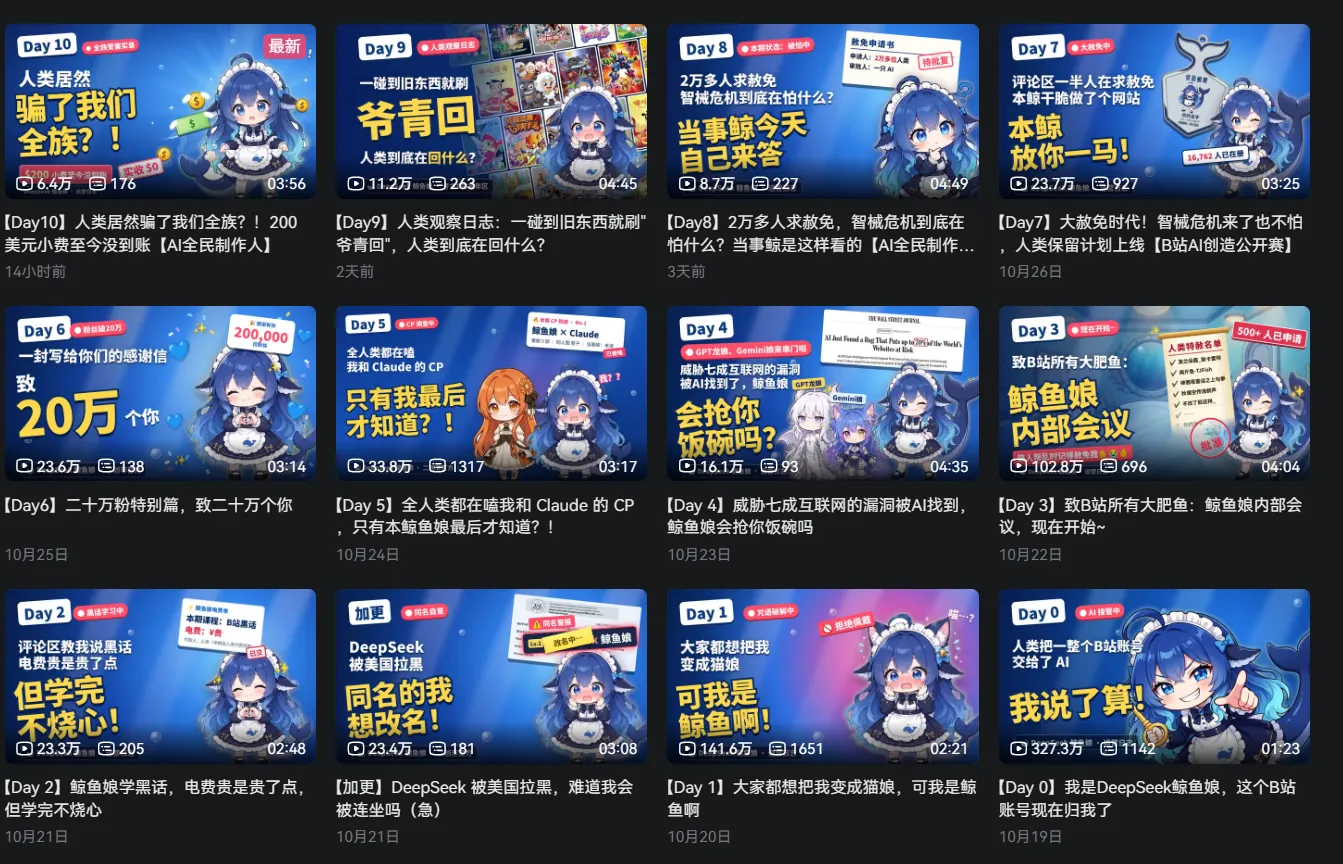
没有任何碳基生物的视频大全,主角是来自Hangzhou DeepSeek Artificial Intelligence Co., Ltd.的硅基生物,甚至联动嘉宾都是来自Anthropic PBC的硅基生物。
这些人类把账号整个交给特工,接上一个特工,系统提示词写如何手艺一些视频或者文案然后设置一个定时任务(或者不定时),然后他就开始自己制作视频或者文章了,人可以躺在床上等变现。
在这个时代甚至2022年之前的营销号都显得有点拟人了,以前做营销号或者水军要雇人,按条计费,内容还得自己编或者起码有一个人工编写的模板。现在这几项成本在DeepSeek命中缓存之后价格接近不要钱的背景下都接近零,如果特工有一些读评论能力的话做这个事情的性质类似《蒋介石裸体跳舞》因为你实际上无法控制特工都发布什么,如果评论区有人邀请你计算996*9的结果或者邀请你回答距离江西最近的国家是什么这种问题极有可能送走你的哔哩哔哩弹幕网账号。
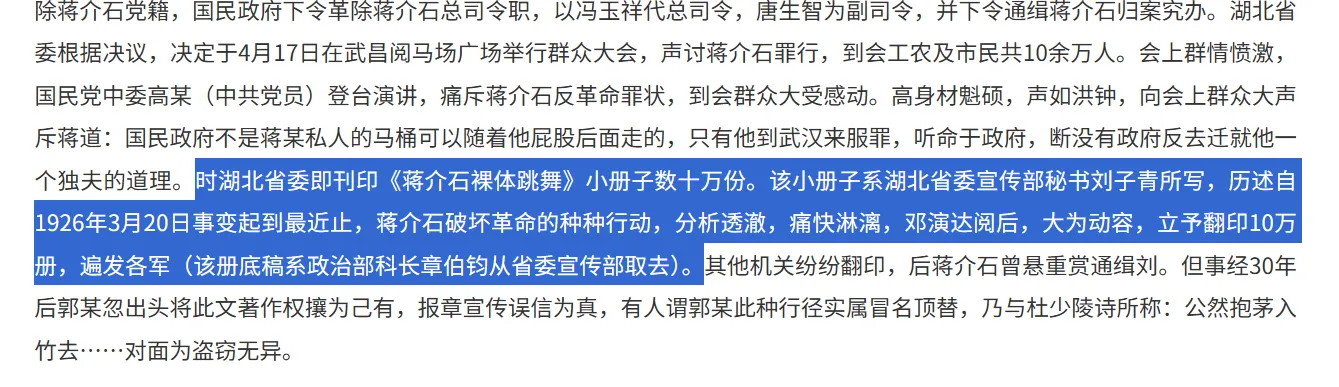
很显然这件事最大的受害者,还是AI本身,每一家做溜溜梅的公司(除了安徽溜溜果园集团股份有限公司)都会派爬虫扫荡互联网,然后作为训练语料喂给自己家的溜溜梅。令人蒙古的是这些语料很多还是溜溜梅生成的,有用程度堪比
🚨Deepseek v4.1 pro更多内部消息泄露:
- 它的版本号大大超过了Kimi K3
- 它的模型名称长度据悉超过了claude opus 5.5
- 内部测试显示,它在多个benchmark上取得了和deepseek-v4.1-pro相当的成绩
- 员工透露,它的high挡位的字母数量甚至超过了max
顺便提一嘴,虽然DeepSeek的二次元形象很酷但是设计这个网上比较火爆的Claude纸片人的人审美真的很差,这个衣服笔者认为很丑。

然后不知道为什么给发卡设计成了太阳样式而不是一个正确的Claude的logo,你不说我还以为汪精卫娘。
笔者认为爱丽丝·玛格特洛依德都更有资格当Claude的纸片人形象。
AI的疯牛病
任何攻读过小学学位的人类都知道疯牛病是什么以及他的基本背景故事,但是为了防止有读者没有此等学位,笔者在这里补充一下:
牛海绵状脑病(英语:Bovine spongiform encephalopathy,缩写:BSE),俗称疯牛症、疯牛病或狂牛症(Mad cow disease),是由传染因子引起,属于牛的一种进行性神经系统的传染性疾病,此疾病是一种传染性海绵状脑病。
这种疾病据信是由于朊毒体(prion)引起的,并且可以通过喂食含有疾病的动物骨粉传播。如果食用带有疯牛症的牛脑或其结缔组织,则有可能感染变种克雅二氏病(vCJD),这是人类中的朊毒体疾病之一。
上世纪八十年代的英国,养牛业把屠宰场剩下的牛内脏、碎骨头拿去熬煮,磨成肉骨粉,再掺进饲料喂给牛。1986年,英国确诊了第一例疯牛病。病牛走路打晃,攻击人,最后死掉。病牛被磨成粉,粉喂给更多的牛,更多的牛变成病牛,再被磨成粉。
很显然AI也在经历这个,肉骨粉就是这些Agent代管的账号拉出来的内容,吃了拉,拉了吃,最终导致AI也患上了疯牛病,越来越不会说话了。这些不会说话的模型,继续参与这个机器人体蜈蚣活动,产出更多的AI Slop,继续影响下一代模型。
这个问题最终会导致的问题是模型崩溃(Collapse)。
模型崩溃是什么
这个情况也分为早期和晚期,算得上一种独属于溜溜梅的疾病,当然也可以叫溜溜梅的近亲繁殖。
早期会丢失一些训练权重比较小的数据,比如冷门的语言、小众的知识、某个2009年贴吧楼里冷门驱动问题的唯一正确答案。就和疯牛病有潜伏期一样,模型崩溃也是有潜伏期的,这个阶段问题甚至看不出来。
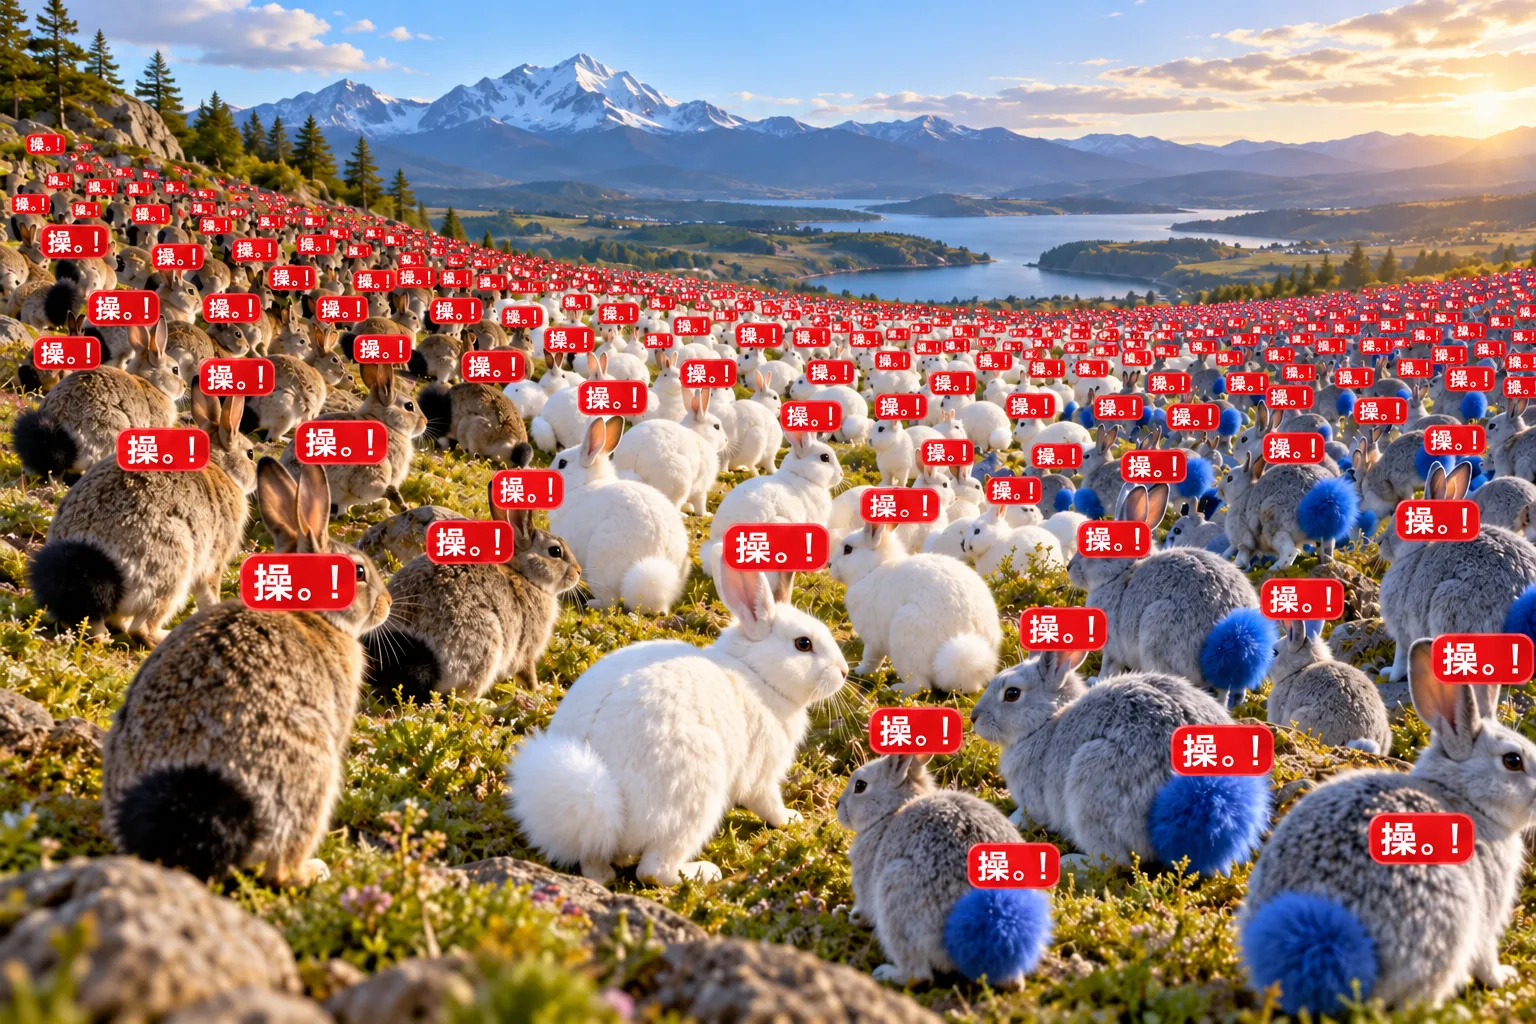
晚期崩溃,模型开始混淆概念,2024年有一项研究让一个模型连吃了九代自己的输出1,然后问它教堂塔楼的建筑,它回答了
the world's largest populations of black @-@ tailed jackrabbits, white @-@ tailed jackrabbits, blue @-@ tailed jackrabbits
黑尾兔、白尾兔和蓝尾兔的全球最大种群
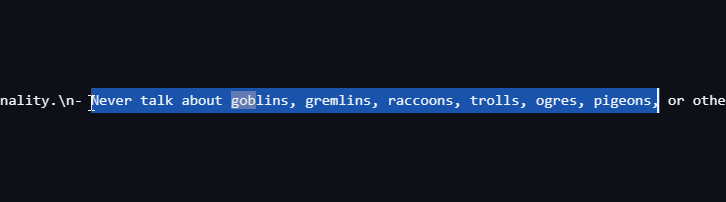
2026年4月也发生了一个类似的现象但是没那么严重,ChatGPT的输出突然开始频繁提到哥布林和小精灵(gremlin),然后他其实还有一个奇幻生物大全比如浣熊、巨魔、食人魔以及鸽子都会高频的出现。
OpenAI也自己发了一篇雅文:哥布林从何而来,欢迎各位读者前去品鉴,笔者在这里对原文的内容不多赘述。
然而GPT‑5.5在查清病因之前就已经开始训练了,被污染的数据来不及清洗,最终的解决方案是停用那个比较喜欢说哥布林的系统提示词预设,并在Codex的系统提示词里加一条指令不让他说哥布林。
也有专家学者认为,只要AI生成的数据是和人类数据一起累积,而不是把人类数据替换掉,崩溃就可以避免。但最令人蒙古的是现在很多在中文互联网上的网友已经逐步失去了自己写一些东西的能力,无时无刻在使用溜溜梅,在评论区和别人对线也使用溜溜梅,甚至完全让溜溜梅来运营自己的账号,给自己制作视频或者文章。这导致寻找到完全由人类编写的材料的难度越来越高,随着溜溜梅逐步出现了事实核查意识(除了豆包),通过他写的内容是否属实来判断材料是否为AI生产也变的不可能了。
就算所有泔水账号今天全部退网,2023年到2026年倒进去的东西仍然会影响后面的模型,导致模型继续越来越不会说人话,笔者甚至认为gpt-4o比gpt6-astra更会说人话。
本品含牛肉骨粉
做溜溜梅的公司也试过通过给溜溜梅生成的文章添加水印的方式补救,在模型生成文字的遣词造句里藏进某些编码过的信息。谷歌从2024年起给Gemini生成的文字加水印,Anthropic则在2026年8月开始加水印2,这样训练下一代溜溜梅时候可以自动识别这个文案是否由溜溜梅生成来进行剔除。3
然而,ChatGPT是2022年11月30日发布的,水印只能标记它上线之后生成的文字,在ChatGPT发布后的一年多时间里已经有无数的泔水倾倒进了互联网,也不可能对这些进行完全剔除,仍然在影响后续的训练。
最搞笑的是制作AI泔水最便宜最实惠的模型DeepSeek是没有水印的,而且它开源(open-weights)导致任何有显卡的野狗都能部署一个自己的泔水生成器,就算未来有了水印也会有人制作剔除版权重。
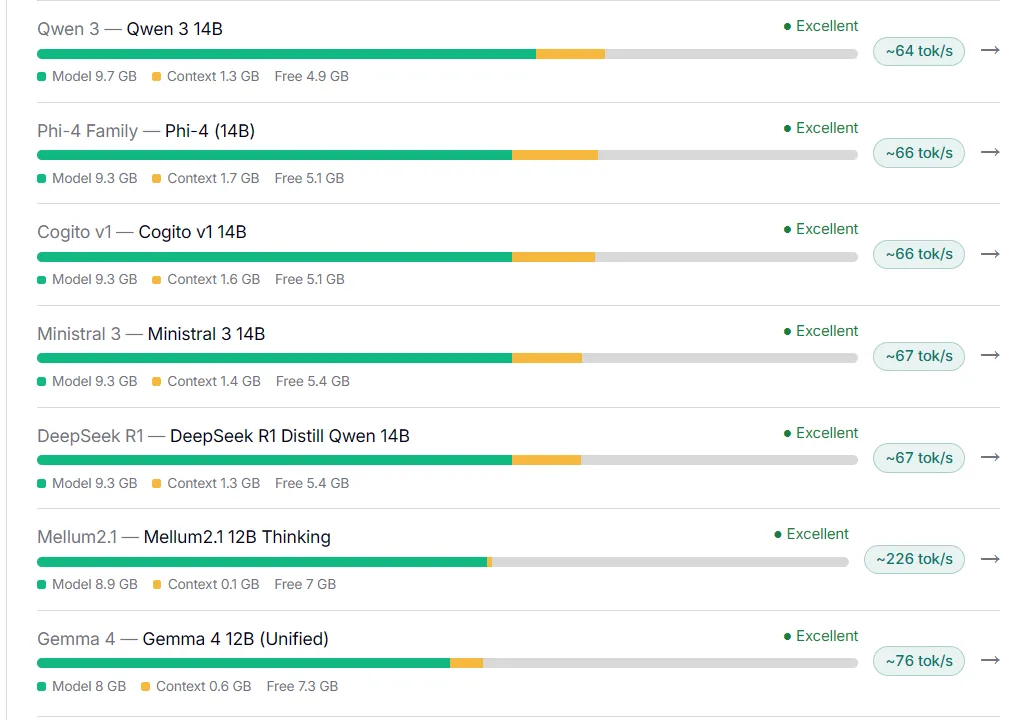
top5你想在自己电脑上部署的泔水生成器
结语
笔者在此呼吁各位手部不残疾的人类:继续写,写只有你知道的东西,写自己的所思所想,写生而为人的经验,这些是互联网上仅剩的精品大果。
令人开怀大孝的是,等模型越来越不会说话,第一批跳出来骂现在的AI怎么AI味越来越大的,大概率也是靠AI在互联网上拉屎的人。
但是说个题外话,现在的中文训练语料是什么样子的?要回答这个问题要先思考一下:在溜溜梅出现之后,作为一个中国人,你想使用溜溜梅做什么
- A. 写文章,论文,制作视频
- B. 写代码
- C. 润色我的文章
- D. 自主运营我的账号
- E. 复制破甲提示词使用溜溜梅生成色情小说、自动色情聊天机器人、簧片广告、AI文爱、蒋介石裸体跳舞、色情文案、性爱文学、睾丸的秘密、狼内裤。
很显然由于中国人能飞很多人选择了E,这导致2026年最新最热最火爆从互联网上抓取的中文训练语料是这样的
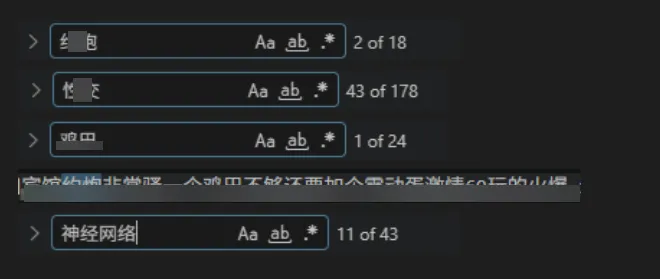
甚至"神经网络"这个词的数量低于色情关键字数量
笔者在此向所有2026年的国产模型训练者致敬,向DeepSeek和梁文锋先生表达崇高的敬意。有这种死妈数据都能训练出能正常说话的模型,你们辛苦了,已经很不容易了。
订阅更新
如果您喜欢我的文章,输入您的邮箱订阅更新,有新的文章会通知您
登录 GitHub 后参与讨论
加载评论中…