Zelix Klass Master 混淆器研究
作者:cubk, EscapistKid, Inkarro, mckuhei
联系:cubk80@gmail.com
源码已发布于:https://github.com/StylesFoundation/OpenZKM
在线Demo:https://zkm.cubk.cn
摘要
本文以 Zelix KlassMaster(ZKM)自身为例,从反调试机制开始,逐层拆解 ZKM 的各项混淆,并给出对应的还原思路。拆解 ZKM 的反调试、引用混淆、参数修改与参数类型混淆、常量加密、控制流和异常混淆,并给出一套基于运行时重放的完整反混淆方案,同时分析 ZKM 的一些暗桩和机制的实现细节。
引言
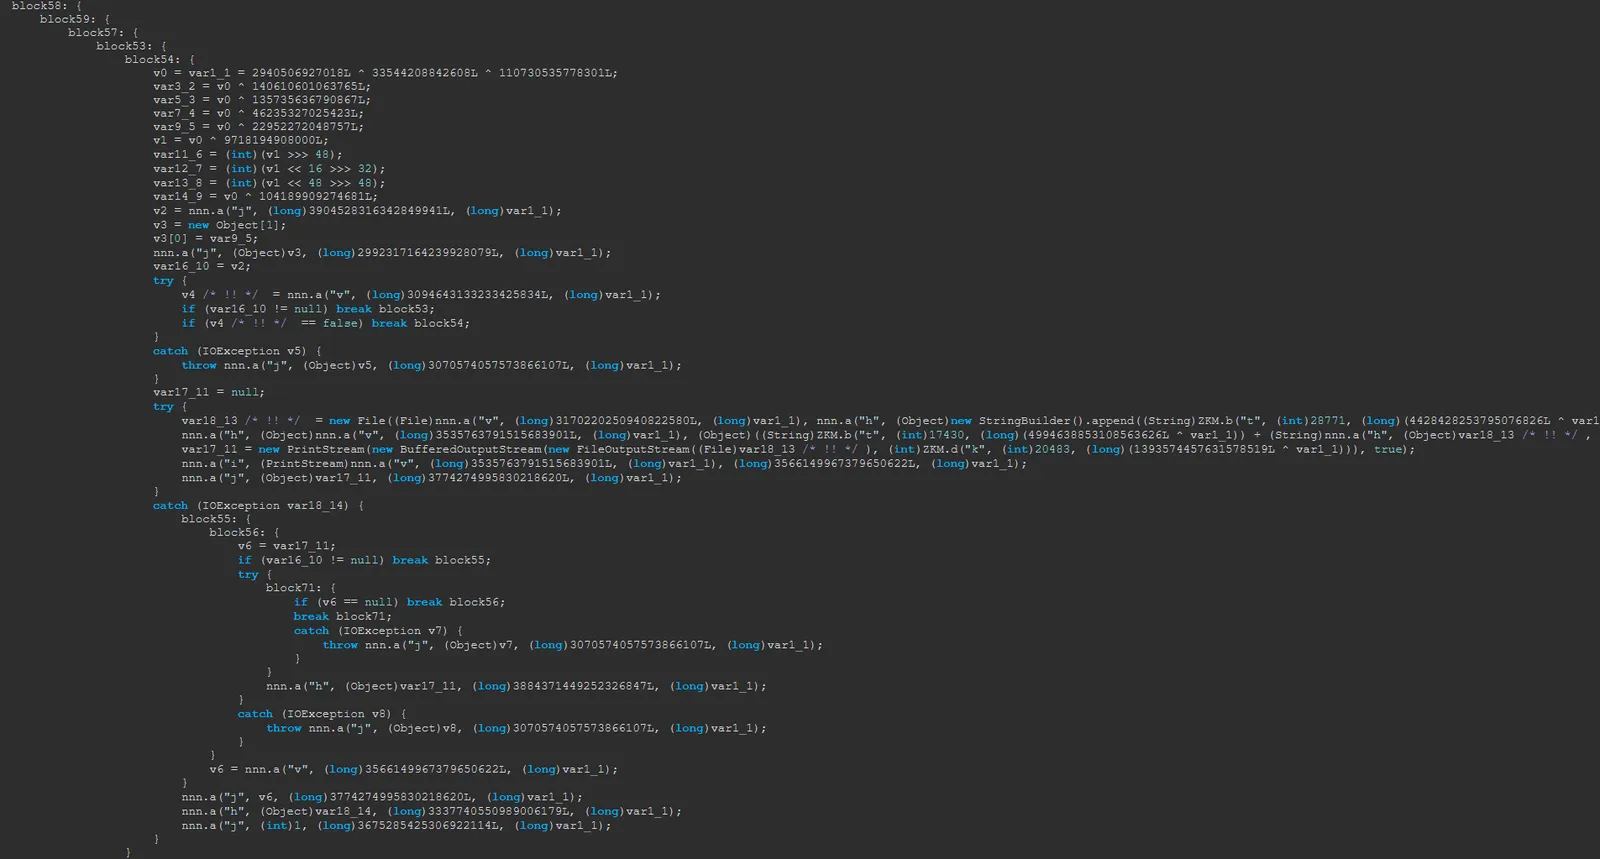
Zelix Klass Master 混淆之后的代码
Zelix KlassMaster ,简称ZKM,是市面上最好的 Java 混淆器,许多公司利用它来保护应用程序,防止被逆向工程和篡改。该工具极其稳定,几乎能够处理任何项目,并可靠地生成可正常运行的混淆后代码。并拥有先进的控制流混淆、字符串加密、整型常量加密、方法参数混淆、引用混淆,同时拥有参数混淆,如果要解密任何方法中的常量,必须完全追踪从程序运行到方法的参数加密链条。
购买ZKM
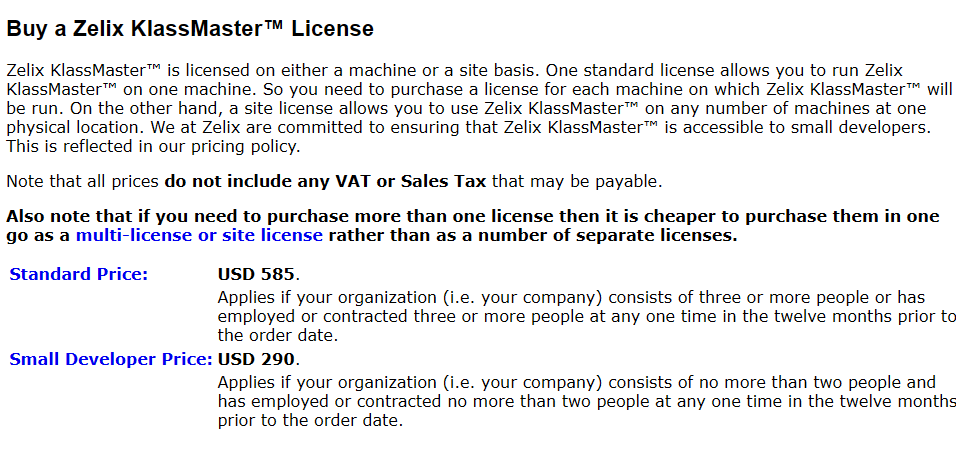
ZKM的价格为290美元对于小团队,585美元对于大团队,当然你也可以下载一个试用版本,试用版本的限制为每个类最多混淆两个方法。当然,笔者出于对 Zelix Pty Ltd 的尊重,还是正价购买了一份正版。
本文所有逆向均基于此正版文件进行,如果 Zelix Pty Ltd 对此有任何意见欢迎来封禁我。但是恳请不要对本文或者我发布的任何材料发送DMCA申请。
名称对照
下文会频繁出现混淆后的类名,对应关系如下:
| 混淆名 | 我们的命名(非官方命名) |
|---|---|
bff |
MasterKeyFactory |
grr |
KeyFactoryBase |
c55 |
FallbackKeyFactory |
nnn |
InvokeDispatcher |
处理流程
ZKM 的各项混淆是互相咬合的,解密流程不是线性的,必须按顺序进行
其中引用混淆和参数修改混淆是互相依赖的:解密 Invoke Dynamic 需要求值方法的额外参数,而追踪额外参数需要先看清调用关系。两者必须迭代推进。
反调试到解密机制
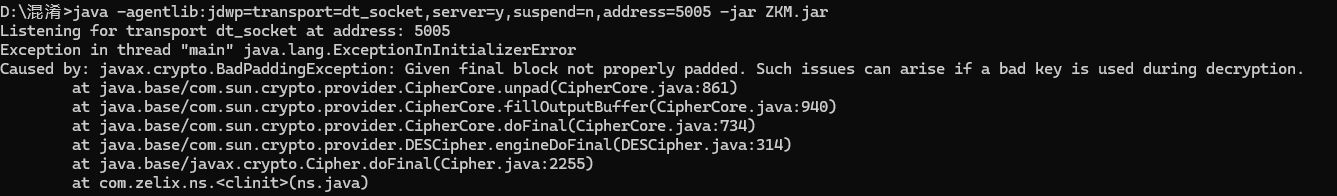
如果使用任何调试参数启动ZKM,会直接弹出一个Given final block not properly padded. Such issues can arise if a bad key is used during decryption异常,你将无法解密任何常量。
因为ZKM的反调试完全基于利用ZKM的解密机制,每个类都会有一个long字段,参与所有混淆运算,我们称其为master key。
在static块中赋值,示例赋值代码:
a = bff.a(6580990762181691679L, -6655629830431801878L, MethodHandles.lookup().lookupClass()).a(159845932320165L) ^ 123909089922007L;其中bff为解密器我们称之为MasterKeyFactory,实现grr,grr为解密器Base为一个接口,这个接口的另一个实现为FallbackKeyFactory。
所以这一段可以理解为
// MethodHandles.lookup().lookupClass() 为获得当前 Class,用于 Class Initialize Order 计算
a = MasterKeyFactory.deriveKeyFactoryForClass(6580990762181691679L, -6655629830431801878L, MethodHandles.lookup().lookupClass()).decrypt(159845932320165L) ^ 123909089922007L;
然后 KeyFactoryBase 的结构如下
// KeyFactory Base
public interface grr {
    public void a(grr var1); // <- setChild

    public int[] b();

    public long a(long var1); // <- decrypt

    public void b(long var1);

    public boolean b(grr var1);
}
派生密钥
位于 MasterKeyFactory,但是实际上并不在这里分发,只是一个供Class使用的入口
// @l: Master Key Seed
// @l2: Fallback Key Seed
// @object: Current Class
public static grr a(long l, long l2, Object object) {
    c55.a(l > 0L); // Junk Code
    grr grr2 = bff.d(l); // 创建 Master
    grr grr3 = bff.d(l2); // 创建 Fallback
    grr grr4 = c55.a(grr2, grr3); // 通过 FallbackKeyFactory 分发
    if (object != null) { // 也是 Junk Code
        m.add(object);
    }
    return grr4;
}
前往 FallbackKeyFactory 检查 a 方法
static grr a(grr grr2, grr grr3) {
    grr grr4 = a.b(grr2, grr3); // a = INSTANCE, FallbackKeyFactory是唯一的,b为下方方法
    return grr4;
}

private grr b(grr grr2, grr grr3) {
    grr grr4 = (grr) this.b.get(grr2); // 按 key 查表,有效的 Root Factory 都会预先注册
    if (grr4 == null) {
        grr4 = this;                   // 查不到 → 返回 FallbackKeyFactory(自身)
    }
    grr grr5 = this.b.put(grr3, grr2); // 将 FallbackKeyFactory注册
    return grr4;
}其中this.b也就是合法的 Root Factory 列表都会在 <init> 块里注册,这些注册出来的 KeyFactory 为 MasterKeyFactory
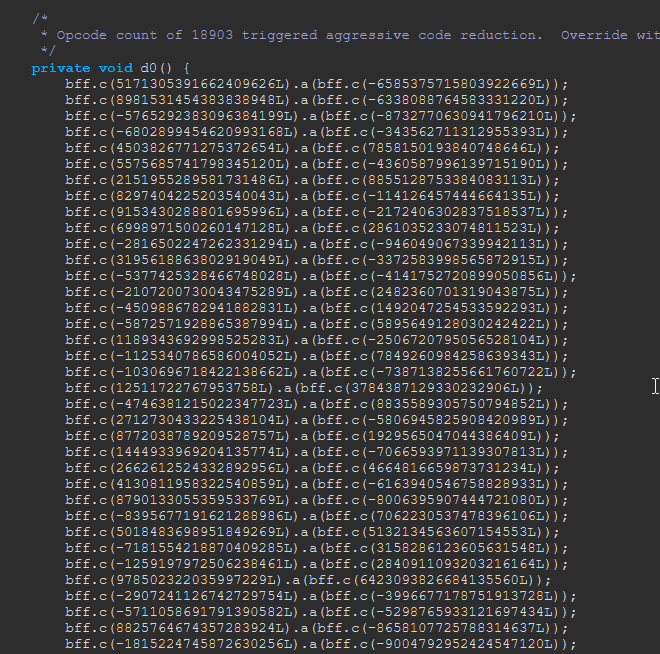
最终这个MasterKeyFactory返回给程序,即可执行到decrypt
解密 Master Key
回到 MasterKeyFactory,在获得 KeyFactory 之后会进入一个有 long 作为参数的解密方法
// decrypt
// @l: decryptKey
@Override
public long a(long l) {
    long l2;
    // 一个非常古典的瞎换乱转,从当前 KeyFactory 的 Seed 求解一个值
    // 以及笔者注意到这个8, 55是硬编码的
    long l3 = this.a(8, 55);
    this.a = l2 = this.a ^ (l ^ this.d); // seed = seed ^ decryptKey ^ key,结合当前类传入的Seed滚码Seed,下次求解是另一个值
    if (this.c != null) { // 检测是否有 Child,如果有 Child 同时滚码 Child 里的 Seed
        this.c.a(l); // 用传入的密钥滚码Child
    }
    return l3;
}

private long a(int n, int n2) {
    return bff.a(
        this.a, // seed
        n, // 8
        n2, // 55
        this.b, // <- 一个本KeyFactory专属的随机偏移表
        this.j // <- Junk Code
    );
}

private static long a(long l, int n, int n2, int[] nArray, long[] lArray) {
    int n3;
    long l2 = 0L;
    int n4 = nArray.length;
    for (int i = 0; i < n4; ++i) {
        long l3 = l & k[i];
        n3 = nArray[i];
        if (l3 == 0L) continue;
        if (n3 > 0) {
            l3 >>>= n3;
        } else if (n3 < 0) {
            l3 <<= ~n3 + 1;
        }
        l2 |= l3;
    }
    n4 = 64;
    long l4 = l2;
    int n5 = n4 - 1 - n2;
    if (n5 > 0) {
        l4 <<= n5;
    }
    if ((n3 = n + n4 - 1 - n2) > 0) {
        l4 >>>= n3;
    }
    return l4;
}
关于 FallbackKeyFactory
回到派生 KeyFactory 的代码,如果这个 Class 不匹配原始注册的 Root Factory(典型情况是脱离原上下文外部调用)就会派生 FallbackKeyFactory。
private grr b(grr grr2, grr grr3) {
    grr grr4 = (grr) this.b.get(grr2); // 按 key 查表,有效的 Root Factory 都会预先注册
    if (grr4 == null) {
        grr4 = this;                   // 查不到 → 返回 FallbackKeyFactory(自身)
    }
    grr grr5 = this.b.put(grr3, grr2); // 将 FallbackKeyFactory注册
    return grr4;
}
FallbackKeyFactory 没有 Child 滚码机制,实际上你可以使用 FallbackKeyFactory 解密出没有 Class Initialization Order 的 Master Key,但是只要使用 FallbackKeyFactory 解密一次就会污染 KeyFactory 注册表,导致无法解密其他的。
反调试做了什么
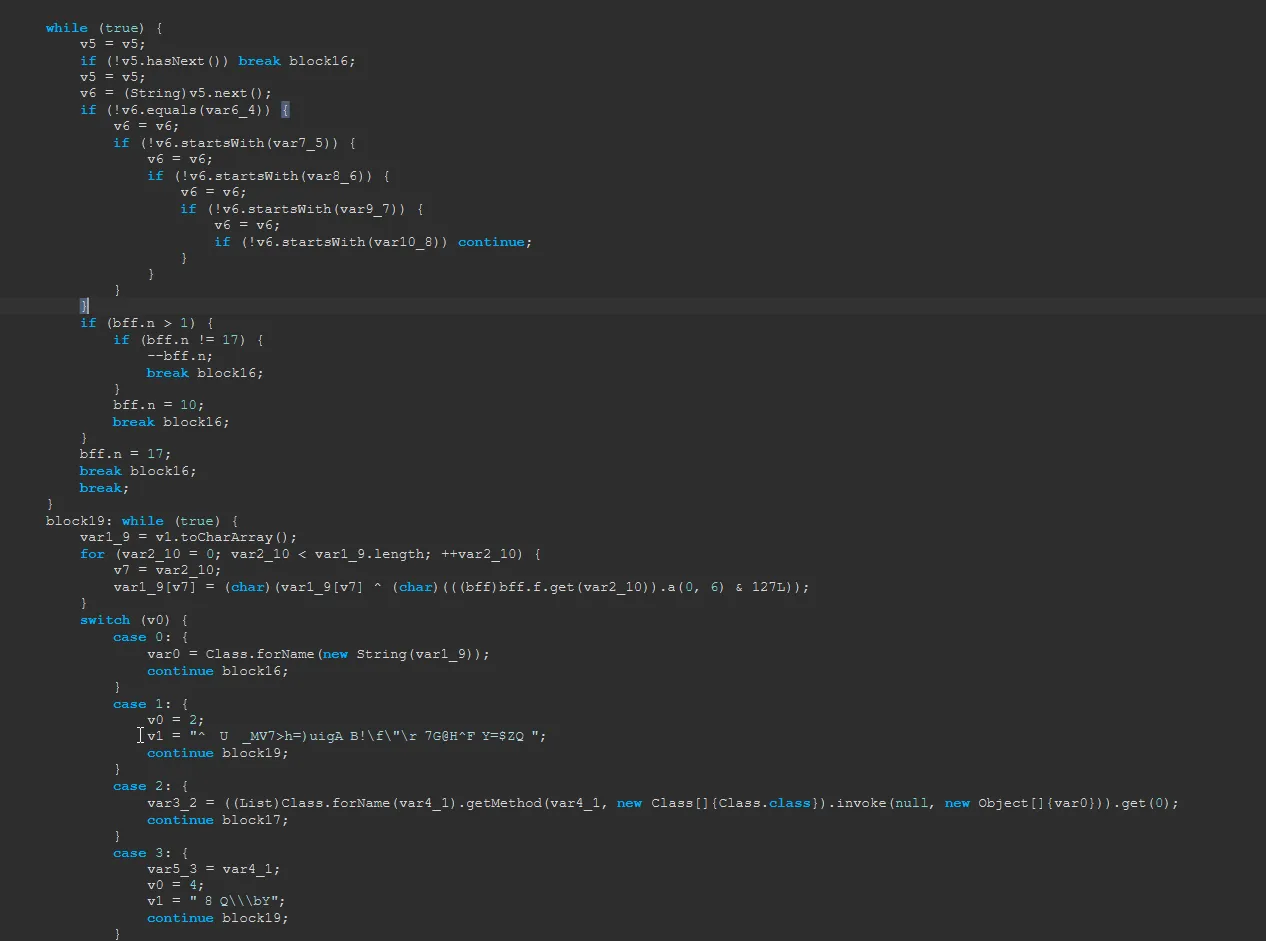
反调试代码实际上位于 MasterKeyFactory 的<init>调用,这段代码有控制流和字符串混淆,简化之后如下:
// 反射获取JVM参数大全
Class<?> runtimeMXBeanClass = Class.forName("java.lang.management.RuntimeMXBean");
Method getPlatformMXBeans = Class.forName("java.lang.management.ManagementFactory").getMethod("getPlatformMXBeans", Class.class);
Object runtimeMXBean = ((List<?>) getPlatformMXBeans.invoke(null, runtimeMXBeanClass)).get(0);
Method getInputArguments = runtimeMXBeanClass.getMethod("getInputArguments");
Collection<String> jvmArgs = (Collection<String>) getInputArguments.invoke(runtimeMXBean);
// 检测是否有非法参数
String xdebugFlag = "-Xdebug";
String xrunjdwpFlag = "-Xrunjdwp";
String agentlibJdwpFlag = "-agentlib:jdwp";
String agentpathFlag = "-agentpath:";
String javaagentFlag = "-javaagent:";
for (String arg : jvmArgs) {
    if(arg.equals(xdebugFlag) || arg.startsWith(xrunjdwpFlag) || arg.startsWith(agentlibJdwpFlag) || arg.startsWith(agentpathFlag) || arg.startsWith(javaagentFlag))
    {
        if (bff.n > 1) { // 破坏MasterKeyFactory里的常量,导致计算出错
            if (bff.n != 17) {
                bff.n--;
            } else {
                bff.n = 10;
            }
        } else {
            bff.n = 17;
        }
    }
}
如果检测到这些调试参数,MasterKeyFactory里的运算常量会被偷偷破坏,导致你将无法正确派生密钥。
Child 机制与 Class Initialization Order
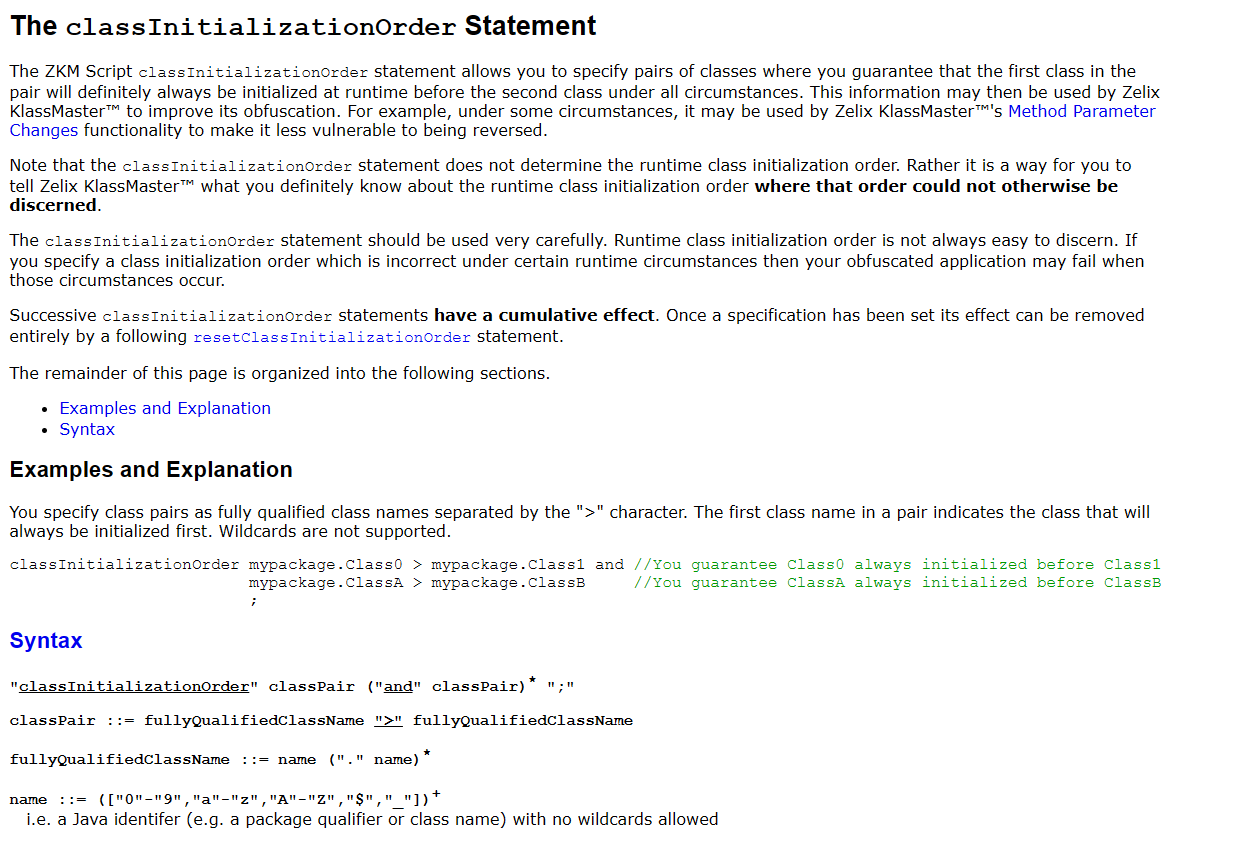
关于 Class Initialization Order 的介绍
// setChild
@Override
public void a(grr grr2) {
    if (this != grr2) { // 防止自己当自己的儿子。
        if (this.c == null) { // 是否有一个 Child,如果没有Child,则设置Child
            this.c = grr2;
        } else {
            this.c.a(grr2); // 如果有一个Child,则设置为Child的Child,这意味着Child可以无限嵌套
        }
    }
}
在初始化 KeyFactory 阶段会在大量硬编码生成的初始化代码中设置很多这样的关系,这样一个 KeyFactory 被调用之后所有 Child 也会跟着滚码。
这就是 Class Initialization Order 的原理,你可以通过配置文件指定类A一定比类B早被加载,加载时必须按照这个顺序加载否则就会无法解密 Master Key。同时继承也有这个效果,因为父类一定比子类先初始化,如果你先初始化(调用static)子类,KeyFactory 就会因为没有滚码 Child 导致密钥派生出错。
在正常的 JVM 里这不是问题,因为 ZKM 生成的初始化顺序本来就是对的,继承关系也保证了父类先于子类初始化。但一旦单独反射调用某个类的解密,或者在虚拟机中按任意顺序执行,Child 就可能还没有被滚码,派生出的密钥就是错的。
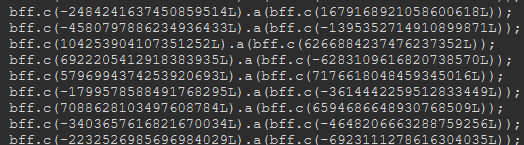
初始化阶段设置initializtion order
解密所有 Master Key (Unordering)
在分析完 ZKM 的 Master Key 计算逻辑之后,我们开始尝试处理这个计算,一次性计算完所有 Class 的 Master Key 防止后续解密出现因初始化顺序不正确而无法解密出正确的逻辑。
核心思路
在上面的分析中我们提到 Master Key 的计算会依赖许多运行时状态。
- 已创建的 KeyFactory
- 注册表中的对象映射关系
- KeyFactory 之间的引用链
如果不处理这些状态直接调用 decrypt 就可能会错误的拿到 FallbackKeyFactory 解密出错误的数据。
所以我们设计了一个利用隔离的虚拟机环境解释解密的运行时,逐步恢复 Factory 对象和注册表状态,再按照对象依赖关系执行解密的方案。
运行时重放
我们使用一个Java字节码解释器(后简称 LittleVM)加载ClassNode并提供完整的运行时环境,由LittleVM独立维护类初始化状态、静态字段和对象实例,一次解密所产生的环境变化可以被观察到。
private static Replay create(Map<String, ClassNode> targets, ClassProvider classes, Layout layout, boolean shortcut) {
    // 把所有运行时需要的 ClassNode 拼起来丢给 LittleVM
    final Map<String, ClassNode> allowed = new HashMap<>(HostMetadata.get().getClasses());
    for (String name : layout.runtimeClasses)
        allowed.put(name, targets.get(name));

    final VMOptions.Builder options = VMOptions.builder()
            .runtimeEnvironment(RuntimeEnvironment.ofClasses(allowed))
            .runtimeCallOnly(true) // 只允许调用合法的 Runtime 方法,防止Sandbox逃逸
            .defaultOnBlock(false) // 在出现调用非法方法时中断并保存上下文
            .automaticClassInitialization(true); // 自动初始化运行时环境

    // 性能优化:笔者发现瞎换乱转方法在所有ZKM版本生成出来的Factory中都一致,在LittleVM遇到这个方法的时候转交给原生JVM执行优化速度
    if (shortcut)
        options.nativeMethod(layout.permute.owner, layout.permute.name, layout.permute.desc, Replay::permute);

    final LittleVM vm = LittleVM.builder()
            .addClasses(targets.values())
            .classResolver(classes::getClassNode)
            .hostFallback(HostFallbackPolicy.PLATFORM_ONLY)
            .options(options.build())
            .build();
    try {
        return new Replay(vm, layout);
    } catch (RuntimeException exception) {
        vm.close();
        throw exception;
    }
}
在构造出LittleVM环境后恢复 ZKM 的运行时状态
Replay首先初始化 Fallback 对象所在的类,然后读取其静态单例以及内部注册表
final Ref field = layout.fallbackInstance;
completed(vm.ensureInitialized(field.owner));
// ZKM 的 FallbackFactory 对象
singleton = Objects.requireNonNull(completed(vm.readStaticField(field.owner, field.name, field.desc)), "fallback singleton");
// 保存解密对象映射关系的 Map
pairs = Objects.requireNonNull(readField(layout.pairMap, singleton), "pair map");
这一步相当于让 ZKM 的解密 Factory 在 LittleVM 中完成启动
运行时注册表处理
我们提到过 Master Key 的计算依赖运行时状态,即使两个解密调用拥有相同的输入密钥,如果它们执行时注册表的状态不同,实际获得的解密对象也可能不同。
所以我们会先尝试从运行时注册表中寻找目标对象,也就是 masterSeed -> create(masterSeed) -> object -> pairs.get(object) -> Factory Object
create(masterSeed) 用来生成查询注册表所需的对象,然后通过 ConcurrentHashMap.get() 找到当前已注册的解密对象,简单来说就是用 Master Seed 模拟创建一个 Factory 然后去查表。
解密准备状态
我们将解密调用划分为两类:
- Ready:当前注册表中已经能够找到有效的解密对象
- Pending:暂时找不到对象,需要其他操作推进运行时状态
for (Site site : pending) {
    // 用上面提到的方案对 Master Seed 进行模拟创建查表
    final Object target = peek(site.masterSeed);

    // 如果获取到了对象并且这个对象不是 FallbackFactory
    if (target != null && target != singleton) {
        ready.add(site);
        targets.put(site, target);
    }
}
效果演示
假设现在有三个解密点 A、B、C,初始注册表如下:
SeedA -> FactoryA
SeedB -> null
SeedC -> null
此时只有 A 点满足执行条件,我们会用 LittleVM 对 A 解密点进行模拟执行,在执行 A 解密点的过程中,ZKM 就可能会对注册表进行修改,从而让我能找到其他解密点的对象。
那么接下来的注册表状态就可能如下:
SeedA -> FactoryA
SeedB -> FactoryB
SeedC -> null
这样 B 解密点就可以在下一轮进入 Ready 状态,这样我们获取对象的顺序就可以有保证。
注意:这一步并不代表我们就做完了所有的顺序处理,正如我上面所说的,目前为止我们还只是对获取对象的顺序有了保证,而 ZKM 的解密对象是可以单独形成引用链的。
遍历对象引用链
我们需要先读取当前对象中指向下一个解密对象的字段。
private Object childOf(Object object) {

    // children 是用 IdentityHashMap 缓存对象之间的引用关系
    if (children.containsKey(object))
        return children.get(object);

    final Ref field = layout.childFields.get(value.getType());
    final Object child = field == null ? null : readField(field, object);
    children.put(object, child);
    return child;
}
有了这个我们就能沿解密对象的引用链向下遍历。
判断对象的可达性
我们不止需要获取对象的引用链,我们还需要判断一个对象是否能够沿引用链访问另一个对象。
private boolean reaches(Object from, Object target) {
    final Set<Object> seen = Collections.newSetFromMap(new IdentityHashMap<>());
    seen.add(from);

    boolean found = false;
    for (Object current = childOf(from); current != null; current = childOf(current)) {
        if (!seen.add(current) || seen.size() > CHAIN_GUARD)
            throw new IllegalStateException("Cyclic or excessive chain");
        found |= current == target;
    }

    return found;
}
假设存在:
A -> B -> C那么:
reaches(A, B) = true
reaches(A, C) = true
reaches(B, C) = true

reaches(C, A) = false
reaches 同时会检测循环引用和长度过长的引用链,防止遍历陷入死循环。
根据 Parent 数量确定执行顺序
获得引用关系后,我们会计算当前 Ready 集合中,每个 Factory 对象有多少路径可以到达它。
例如:
A -> B -> C对应结果为
| 对象 | 数量 | 顺序 |
|---|---|---|
| A | 0 | 1 |
| B | 1 | 2 |
| C | 2 | 3 |
我们会优先执行 Parent 数量最少的对象,这样就能做到按顺序依次解密所有的 Master Key 了。
绕过反调试
在 LittleVM 执行到反调试代码时会触发 调用保护 而中断模拟执行,返回 ExecutionStatus.BLOCKED 并保存运行上下文,在判断到上下文为获取 vmArgs 时向栈内置空列表来绕过反调试检测。
你也可以通过下面的代码来绕过反调试
final Field jvm = ManagementFactory.getRuntimeMXBean().getClass().getDeclaredField("jvm");
jvm.setAccessible(true);
final Object object = jvm.get(ManagementFactory.getRuntimeMXBean());
final Field vmArgs = object.getClass().getDeclaredField("vmArgs");
vmArgs.setAccessible(true);
vmArgs.set(object, new ArrayList<>());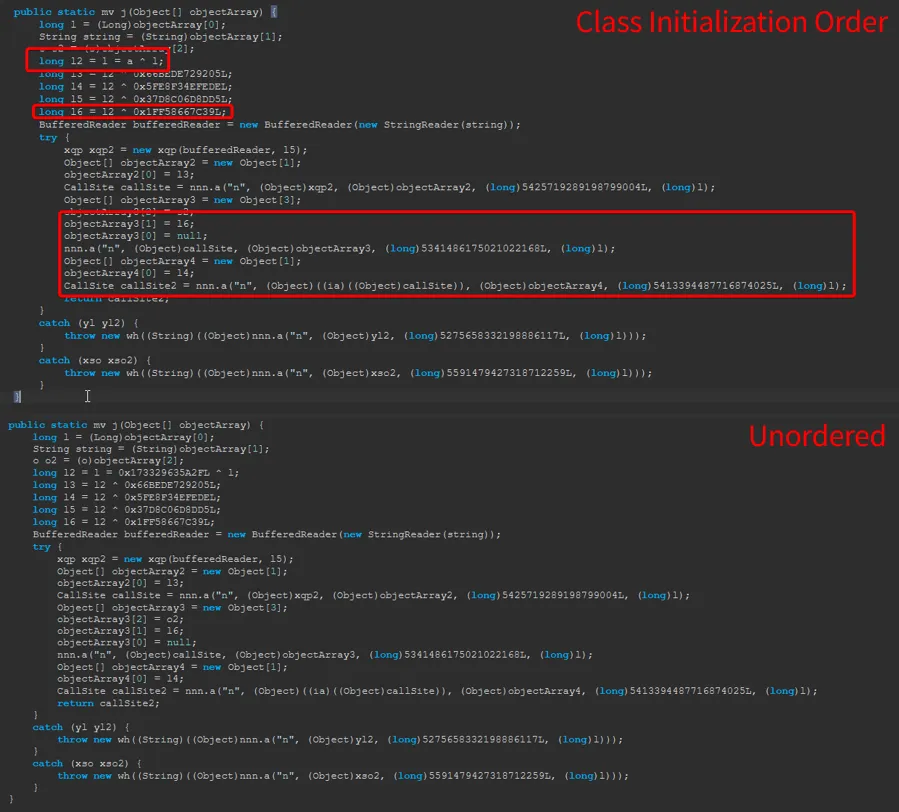
在所有Master Key解密之后,通过字段引用回填到各个方法内,现在所有局部变量均可以通过上下文运算求值,这为后续解密混淆运算打下了基础。
引用混淆(Reference Obfuscation)
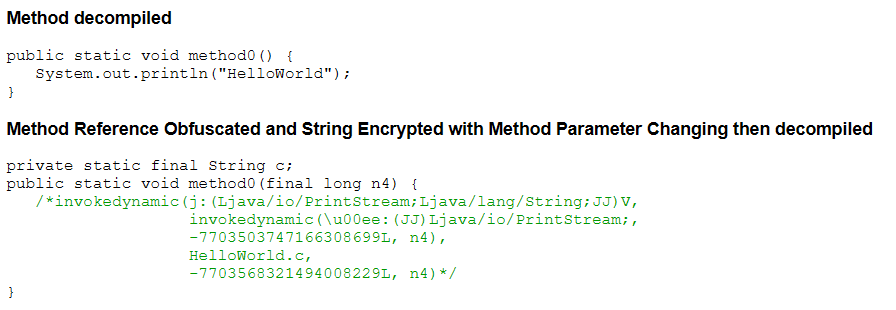
引用混淆(Reference Obfuscation)就是将一般的调用变成一个Invoke Dynamic调用,然后通过ZKM生成的Bootstrap方法导到目标方法和字段,示例Bootstrap方法:
private static CallSite b(MethodHandles.Lookup lookup, String string,MethodType methodType) {
    MutableCallSite mutableCallSite = new MutableCallSite(methodType);
    try {
        mutableCallSite.setTarget(MethodHandles.explicitCastArguments(MethodHandles.insertArguments(cfr_ldc_0().asCollector(Object[].class, methodType.parameterCount()), 0, lookup, mutableCallSite, string), methodType));
    }
    catch (Exception exception) {
        throw new RuntimeException("com/zelix/_a" + " : " + string + " : " + methodType.toString(), exception);
    }
    return mutableCallSite;
}

static MethodHandle cfr_ldc_0() {
    try {
        return MethodHandles.lookup().findStatic(_a.class, "b", MethodType.fromMethodDescriptorString("(Ljava/lang/invoke/MethodHandles$Lookup;Ljava/lang/invoke/MutableCallSite;Ljava/lang/String;[Ljava/lang/Object;)Ljava/lang/Object;", null));
    }
    catch (NoSuchMethodException | IllegalAccessException except) {
        throw new IllegalArgumentException(except);
    }
}
被混淆的调用点在字节码里长这样:
ldc 5425719289198799004L
lload j2
invokedynamic n (Ljava/lang/Object;Ljava/lang/Object;JJ)Lcom/zelix/v6; .handle H_INVOKESTATIC com/zelix/nnn.a (Ljava/lang/invoke/MethodHandles$Lookup;Ljava/lang/String;Ljava/lang/invoke/MethodType;)Ljava/lang/invoke/CallSite; .args .end
原本的方法多出来两个long输入,用于解密Invoke Dynamic调用,其中这个cfr_ldc_0里指向当前类的Dispatcher方法。
其中也分为两种,一种是在当前类中解密字符串和数字,我们称为ConstantDispatcher,另一种是从一个很大的注册表类里调用方法,我们称为InvokeDispatcher
Constant Dispatcher
解密字符串
private static Object b(MethodHandles.Lookup lookup, MutableCallSite mutableCallSite, String string, Object[] objectArray) {
    int n = (Integer)objectArray[0];
    long l = (Long)objectArray[1];
    String string2 = _a.b(n, l);
    MethodHandle methodHandle = MethodHandles.constant(String.class, string2);
    mutableCallSite.setTarget(MethodHandles.dropArguments(methodHandle, 0, Integer.TYPE, Long.TYPE));
    return string2;
}
解密数字
private static int c(MethodHandles.Lookup lookup, MutableCallSite mutableCallSite, String string, Object[] objectArray) {
    int n = (Integer)objectArray[0];
    long l = (Long)objectArray[1];
    int n2 = h0.c(n, l);
    MethodHandle methodHandle = MethodHandles.constant(Integer.TYPE, n2);
    mutableCallSite.setTarget(MethodHandles.dropArguments(methodHandle, 0, Integer.TYPE, Long.TYPE));
    return n2;
}
Invoke Dispatcher
典型调用:
nnn.a<"k">(var10007, -7487940343502911222L, var7);其中a为 Invoke Dispatcher Bootstrap Method,通过两个long查询一个表来得到目标方法/字段。
public static MethodHandle a(MethodHandles.Lookup lookup, MutableCallSite mutableCallSite, String string, MethodType methodType, long l, long l2) {
    // 解码 Invoke Dynamic 里的第一个字符,可以判断调用类型是什么
    int n = string.charAt(0) ^ (int)l2 & 7;
    MethodHandle methodHandle = null;
    Field field = null;
    Method method = null;
    try {
        // 字段相关符号
        if (n == 104 || n == 108 || n == 113 || n == 110) {
            // 解析字段
            field = nnn.c(l, l2);
            Class<?> clazz = field.getDeclaringClass();
            String string2 = field.getName();
            Class<?> clazz2 = field.getType();
            methodHandle = n == 104 ? lookup.findGetter(clazz, string2, clazz2) : (n == 108 ? lookup.findSetter(clazz, string2, clazz2) : (n == 113 ? lookup.findStaticGetter(clazz, string2, clazz2) : lookup.findStaticSetter(clazz, string2, clazz2)));
        } else {
            // 解析方法
            method = nnn.d(l, l2);
            Class<?> clazz = method.getDeclaringClass();
            String string3 = method.getName();
            MethodType methodType2 = MethodType.methodType(method.getReturnType(), method.getParameterTypes());
            methodHandle = n == 111 ? lookup.findVirtual(clazz, string3, methodType2) : (n == 109 ? lookup.findStatic(clazz, string3, methodType2) : lookup.findSpecial(clazz, string3, methodType2, clazz));
        }
        return MethodHandles.dropArguments(methodHandle, methodType.parameterCount() - 2, Long.TYPE, Long.TYPE);
    }
    catch (Exception exception) {
        StringBuilder stringBuilder = new StringBuilder();
        stringBuilder.append(exception.getClass().getName()).append(" : ").append(field != null ? field.toString() : (method != null ? method.toString() : " null ")).append(" : ").append(exception.toString());
        throw new RuntimeException(stringBuilder.toString());
    }
}

public static Method d(long l, long l2) {
    // 通过两个long解密一个index,这个index用于查询方法表
    int n = nnn.a(l, l2);
    // 查询方法表中的对象
    Object object = a[n];
    // 判断对象类型、如果是String则是类、方法名、Desc格式,需要先解析,如果不是则直接返回方法
    if (object instanceof String) {
        Class<?>[] classArray;
        Class clazz;
        Class clazz2;
        Class[] classArray2;
        int n2;
        String string;
        Class clazz3;
        block10: {
            String string2 = b[n];
            int n3 = string2.indexOf(8);
            clazz3 = nnn.b(Long.parseLong(string2.substring(0, n3), 36), 0L);
            int n4 = string2.indexOf(8, ++n3);
            string = string2.substring(n3, n4);
            int n5 = -1;
            int n6 = n4;
            do {
                ++n5;
                ++n6;
            } while ((n6 = string2.indexOf(8, n6)) > -1);
            n2 = n5 - 1;
            classArray2 = new Class[n2];
            clazz2 = null;
            n6 = n4 + 1;
            for (int i = 0; i < n5; ++i) {
                int n7 = string2.indexOf(8, n6);
                clazz2 = nnn.b(Long.parseLong(string2.substring(n6, n7), 36), 0L);
                if (i < n2) {
                    classArray2[i] = clazz2;
                }
                n6 = n7 + 1;
            }
            clazz = clazz3;
            do {
                if ((classArray = nnn.a(clazz, string, clazz2, n2, classArray2)) != null) {
                    nnn.a[n] = classArray;
                    return classArray;
                }
                if (clazz.getName().equals("java.lang.Object")) break block10;
            } while ((clazz = clazz.getSuperclass()) != null);
            clazz = nnn.b(5620362211605642L, 0L);
        }
        clazz = clazz3;
        while (true) {
            if ((classArray = clazz.getInterfaces()) != null) {
                for (int i = 0; i < classArray.length; ++i) {
                    Method method = nnn.b(classArray[i], string, clazz2, n2, classArray2);
                    if (method == null) continue;
                    nnn.a[n] = method;
                    return method;
                }
            }
            if (clazz.getName().equals("java.lang.Object")) break;
            if ((clazz = clazz.getSuperclass()) != null) continue;
            clazz = nnn.b(5620362211605642L, 0L);
        }
        StringBuffer stringBuffer = new StringBuffer();
        stringBuffer.append("NoSuchMethodException in ").append(clazz3.getName()).append(' ').append(clazz2.getName()).append(' ').append(string).append('(');
        int n8 = 0;
        while (n8 < n2) {
            stringBuffer.append(classArray2[n8].getName());
            if (++n8 >= n2) continue;
            stringBuffer.append(", ");
        }
        stringBuffer.append(')');
        throw new RuntimeException(stringBuffer.toString());
    }
    return (Method)object;
}
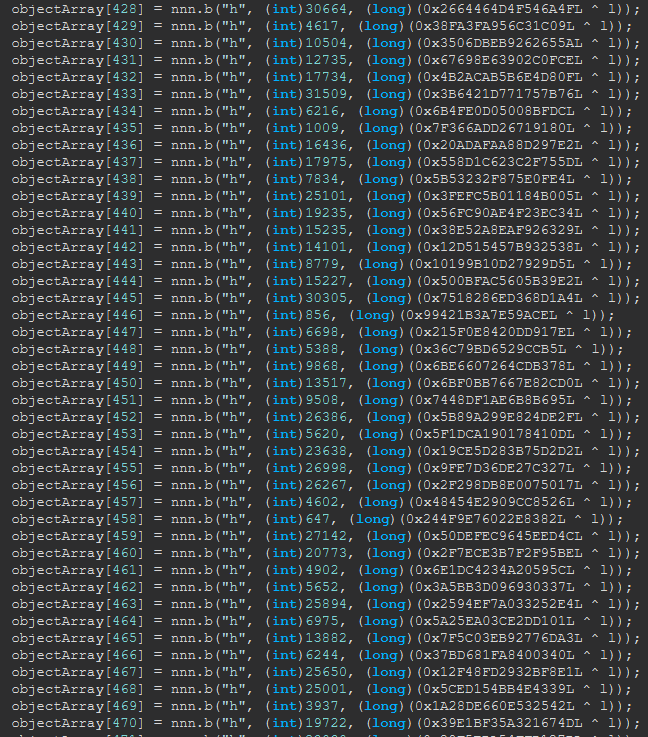
其查询的那个Object[]表在初始化时会塞入所有方法/字段的Owner、Name和Descriptor
最轮椅的还原
如果你过于闲,你大可还原笔者上述的所有逻辑然后真实的解密所有引用来实现静态解密,但是笔者实际上使用了一个更加轮椅的方案
Tip
IMPL_LOOKUP 是 MethodHandles.Lookup 中的一个 private static 字段。它的 lookupClass 是 Object,权限模式为 TRUSTED 为JDK内部使用的 Lookup 没有任何反射限制。
实际上,目前所有的MasterKey已解密,代表所有局部变量也可以求值,这意味着还原相当简单,只需要模拟执行。
两个long通常一个是直接写出来的,另一个是用Parameter Changes注入的参数异或出来的。
带着那两个long获得MethodHandle,注意 InvokeDispatcher 最后一个指令是 MethodHandles.dropArguments,它为了丢掉末尾两个 long,会把原始句柄包成一个 BoundMethodHandle,原始句柄存放在它的 argL0 字段里,需要先反射取出原始MethodHandle。
if (handle.getClass().getName().startsWith("java.lang.invoke.BoundMethodHandle$Species_L")) {
    Field original = handle.getClass().getDeclaredField("argL0"); // <- argL0是原始的MethodHandle
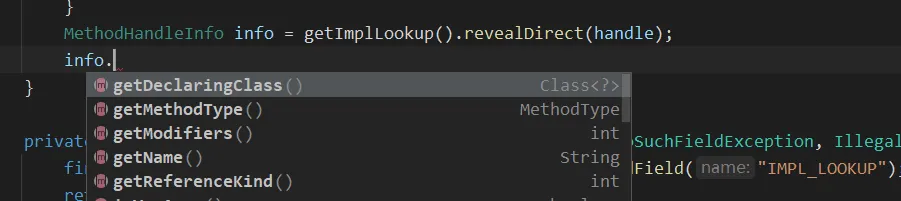
}然后使用IMPL_LOOKUP的revealDirect获得MethodHandleInfo,内部提供的信息足以使用ASM重建一个MethodInsnNode出来。
其中getMethodType包含Method Parameters,可以反推Descriptor出来。
重建MethodInsnNode之后进行替换原始的InvokeDynamicInsnNode,即可完全解密所有引用混淆。
参数类型混淆(Method Parameter Obfuscation)
ZKM有一个方法参数混淆功能,会将方法参数变成一个Object[],同时所有调用也会改成装配Object Array,再配合类似 overloadaggressively 的混淆配置,会生成大量除了返回类型参数和名字完全一样的方法来恶心人,所以也不能通过名字来推测,即使解密了Invoke Dynamic。
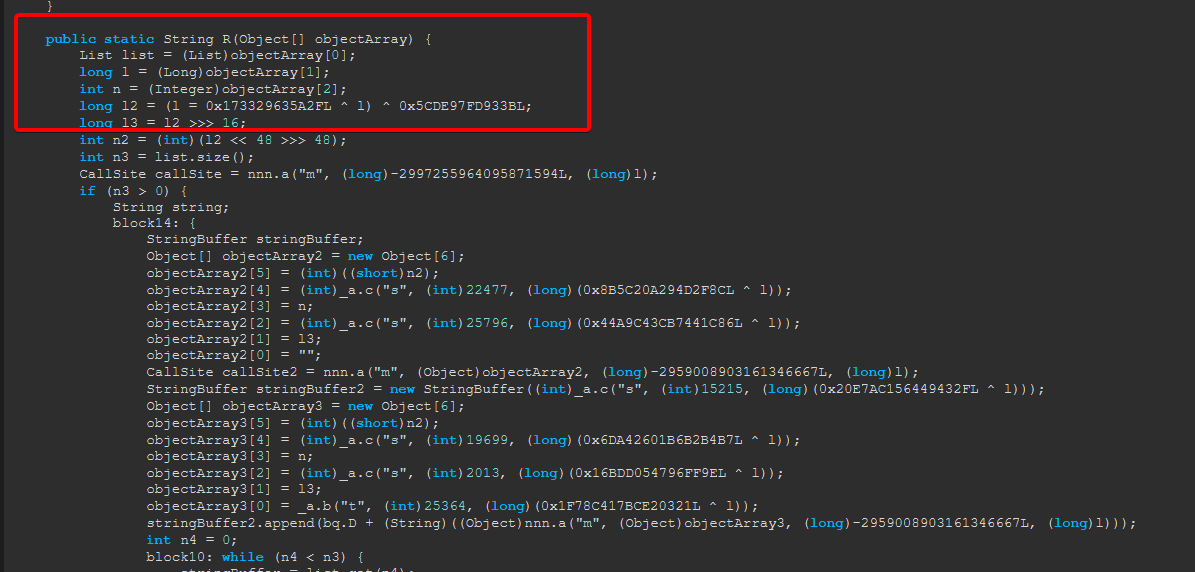
很显然对于参数的调用有一个固定模式
dup → iconst → aaload → checkcast → *unbox
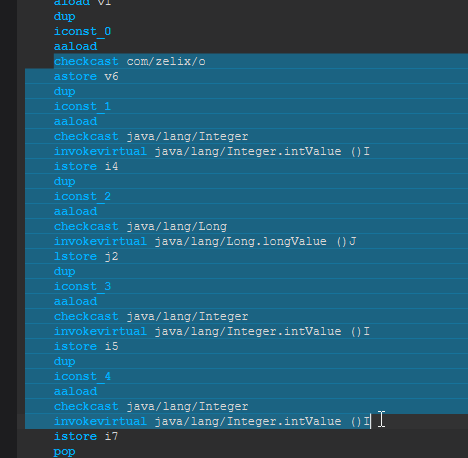
如果有unbox指令例如invokevirtual java/lang/Integer.intValue ()I,类型就是拆箱后的基本类型,没有拆箱,类型就是checkcast的Type,参数顺序完全由数组下标排序,和指令先后无关。
示例:
aaload
**checkcast com/zelix/o**
astore v6
dup
iconst_1
aaload
checkcast java/lang/Integer
**invokevirtual java/lang/Integer.intValue ()I**
istore i4
dup
iconst_2
aaload
checkcast java/lang/Long
**invokevirtual java/lang/Long.longValue ()J**
lstore j2
dup
iconst_3
aaload
checkcast java/lang/Integer
**invokevirtual java/lang/Integer.intValue ()I**
istore i5
dup
iconst_4
aaload
checkcast java/lang/Integer
**invokevirtual java/lang/Integer.intValue ()I**
istore i7
pop可推断出原始Descriptor为(Lcom/zelix/o;IJII)V,即可修复方法参数。
处理Local表
参数修复之后,方法体里对参数的读取仍然是解包参数的局部变量,而它们现在应该直接读参数。所以还需要把局部变量表重新排一遍。
实例方法的 this 固定占 0 号槽,参数从 1 号槽开始依次往后排,long 和 double 各占两个槽。以此类推即可修复所有参数引用。
还有一种特殊情况就是这个参数根本没有引用,因为ZKM会给()V这种无参方法也变成Object[]输入,可以直接恢复成()。
参数继承
ZKM 处理参数混淆时会把整个继承表里的这个方法的参数一起变成 Object[],所以父类或接口里一定还有一个 i([Ljava/lang/Object;)V。因此我们需要建立一个ClassHierarchy,之后可以根据各个有具体代码的方法推断出整个继承或实现表里的Override方法的参数。
修复引用
对于方法的调用点,也有Object[]装箱代码需要处理,示例字节码
aload this
aload v6
iload i4
iload i5
iload i7
lload j10
sipush 31703
ldc 4810934370959675205L
lload j2
lxor
invokedynamic t (IJ)Ljava/lang/String; .handle H_INVOKESTATIC com/zelix/_a.b (Ljava/lang/invoke/MethodHandles$Lookup;Ljava/lang/String;Ljava/lang/invoke/MethodType;)Ljava/lang/invoke/CallSite; .args .end
bipush 6
anewarray java/lang/Object
dup_x1
swap
iconst_5
swap
aastore
dup_x2
dup_x2
pop
invokestatic java/lang/Long.valueOf (J)Ljava/lang/Long;
iconst_4
swap
aastore
dup_x1
swap
invokestatic java/lang/Integer.valueOf (I)Ljava/lang/Integer;
iconst_3
swap
aastore
dup_x1
swap
invokestatic java/lang/Integer.valueOf (I)Ljava/lang/Integer;
iconst_2
swap
aastore
dup_x1
swap
invokestatic java/lang/Integer.valueOf (I)Ljava/lang/Integer;
iconst_1
swap
aastore
dup_x1
swap
iconst_0
swap
aastore
ldc -6992759839369705212L
lload j2
invokedynamic n (Ljava/lang/Object;Ljava/lang/Object;JJ)V .handle H_INVOKESTATIC com/zelix/nnn.a (Ljava/lang/invoke/MethodHandles$Lookup;Ljava/lang/String;Ljava/lang/invoke/MethodType;)Ljava/lang/invoke/CallSite; .args .end
对应Java代码
Object[] objectArray3 = new Object[6];
objectArray3[5] = _a.b("t", (int)31703, (long)(0x42C3DF522AC4CF45L ^ l));
objectArray3[4] = l4;
objectArray3[3] = n3;
objectArray3[2] = n2;
objectArray3[1] = n;
objectArray3[0] = o2;
nnn.a("n", (Object)this, (Object)objectArray3, (long)-6992759839369705212L, (long)l);
anewarray 之前的栈内容就是原始参数,所以修复引用的方法为删除从数组长度(bipush 6)到调用指令之前的所有指令,并把调用的 Descriptor 换成修复后的。
ZKM 27.0.0 的更改
为了防止自动识别,新版本 ZKM 尽可能节省了拆包和checkcast
如果一个参数在方法内只被使用一次且目标可以传入Object,例如List.add,ZKM就不会生成checkcast指令。
示例:
public static void putValue(Typed arg) {
    list.add(arg);
}
27.0.0 混淆将会成为
public static void putValue(Object[] arg) {
    list.add(arg[0]);
}节省掉了checkcast,单看当前方法体已经无法推断出 Typed 类型了。
虽然当前方法里的checkcast被节省了,但是Caller Method可能因为在多处使用了该变量而在方法开头进行了checkcast或者该变量在Caller Method里store到局部变量上下文有明确的类型。
或者如果一个方法有三处调用,向上追踪后可以发现传入类型都实现了某个接口或者继承了某个类,那么显然这个参数就是父类或接口,可以通过打分机制计算出最有可能的类型。
内联
回填之后,对额外的参数的运算会是一个固定的lload一个数值,可以直接根据堆栈折叠为直接引用而不是局部变量,这样所有调用前就恢复为常量了,为解密常量打下了基础。
参数修改混淆(Method Parameter Changes)
除了参数混淆(将参数修改为Object[]),ZKM还有一个功能叫参数修改混淆(Method Parameter Changes),会给方法发配一个额外的long参数,这个参数在方法里参与混淆运算,并在调用下一个方法时将这个值异或。
这意味着你必须完全追踪所有调用,从main方法往下顺,才能算出每个方法的long密钥的值。其中最大的阻碍是 Lambda 方法。ZKM 同样会给 Lambda 的实现方法加上额外的参数,调用方在创建 Lambda 时把它作为参数压栈传入,同时 LambdaMetafactory 的 bsmArgs[1](实现方法的 Handle)的描述符里也带额外参数,两处都需要修复。
在部分情况下他会变异为一种更加恶心的形态
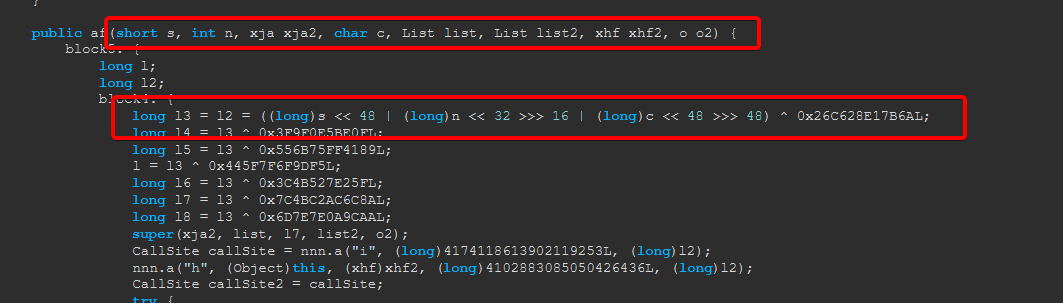
不会直接传入一个long而是传入多个short, int, char 然后拼装出这个方法的long,其组装方式为char代表低16位,int代表中间32位,short代表高16位,字节码为
iload i1
i2l
bipush 48
lshl
iload i2
i2l
bipush 32
lshl
bipush 16
lushr
lor
iload i4
i2l
bipush 48
lshl
bipush 48
lushr对于这种模式需要先根据传入的类型反解出原始long并折叠运算,才能继续建立调用追踪。
在解密了引用混淆之后,只要妥善处理Lambda,就可以很容易的建立调用结构,得到他对参数处理的xor值即可算出每个方法对应的long值,然后就可以进行回填并擦除额外的参数,因为回填之后额外的参数不再被引用。
解密常量
很显然在解密了Invoke Dynamic和Parameter Changes之后,ZKM的字符串和数字混淆看起来就堪比一个屎。由于Invoke Dynamic被解密现在他就是非常简单的(II)Ljava/lang/String;或(IJ)I。
只需要获得调用前栈上两个参数模拟执行这个解密方法,他就会给明文返回了,直接使用ldc回填替换MethodInsnNode即可完成字符串解密,数字同理。
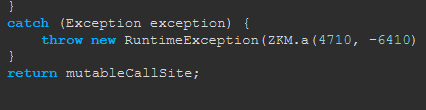
没有 Invoke Dynamic 的字符串混淆
控制流混淆(Control Flow Obfuscation)
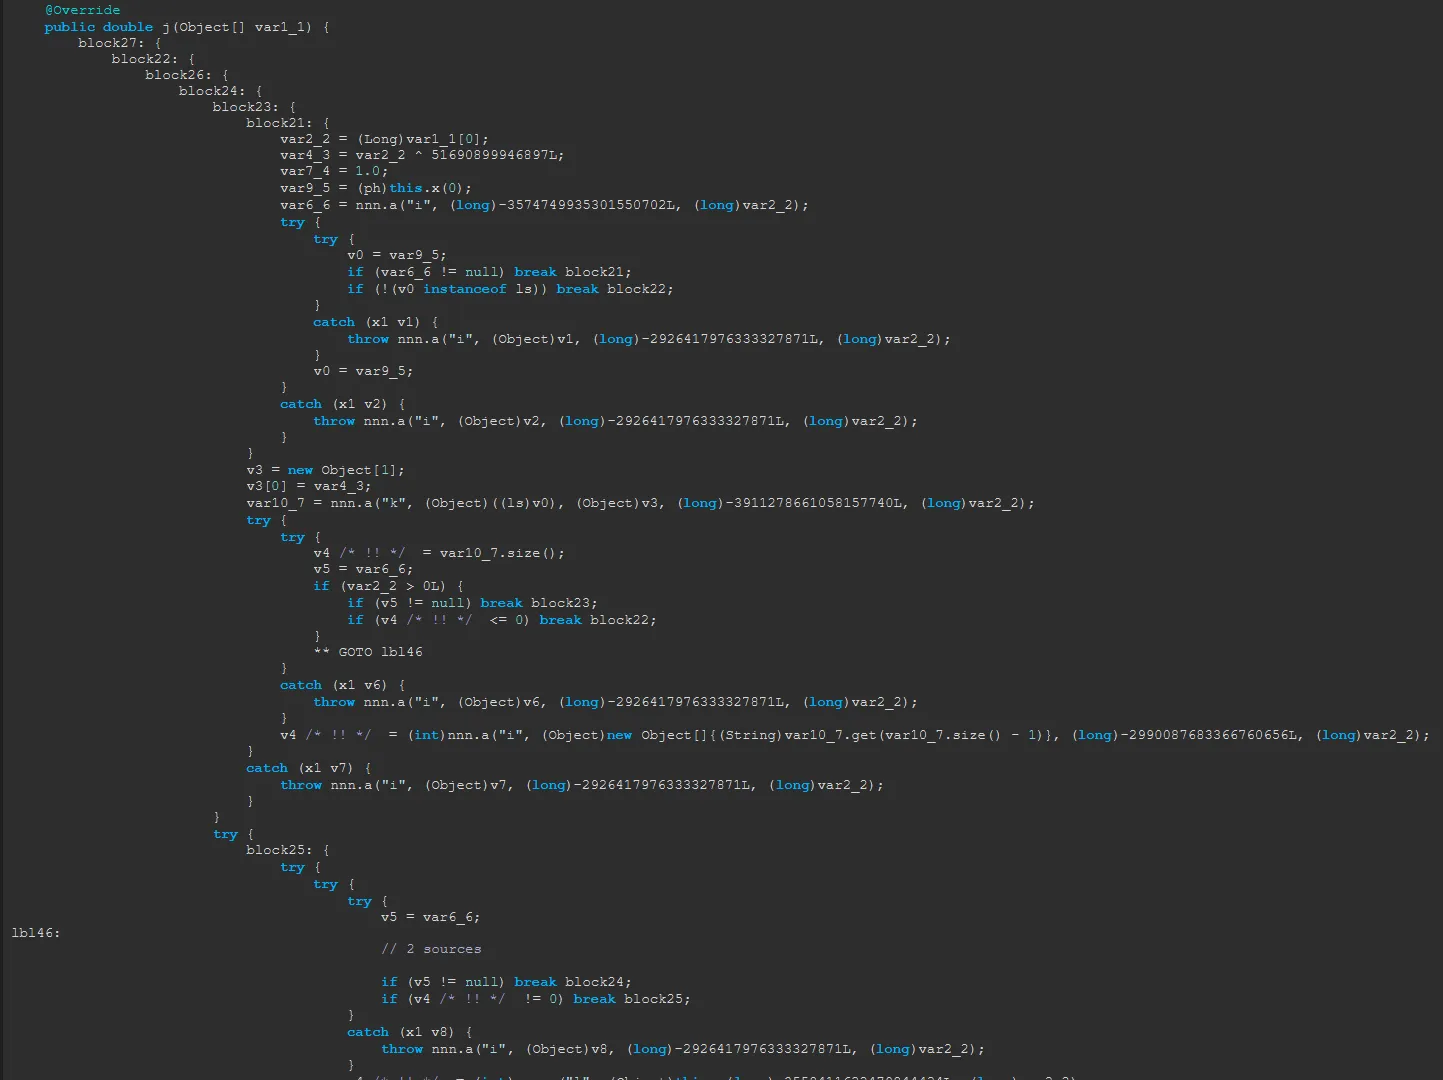
ZKM 的控制流混淆是利用 Invoke Dynamic 保护不透明谓词进行假跳(goto),只不过由于反编译器太蠢对goto处理的不太好导致反编译出来了一坨大的。如果他判断是ifeq而不是goto,那么这个方法应该是这样的
public double j(Object[] args) {
    long key = (Long) args[0];
    long k1 = key ^ 51690899946897L;
    double result = 1.0;
    ph p = (ph) this.x(0);
    // 不透明谓词,用于假跳,他返回的是null
    Object flag = nnn.a("i", -3574749935301550702L, key);

    try {
        if (flag == null) { // 真
            if (!(p instanceof ls)) {
                return result;
            }
        }

        List list = ((ls) p).k(new Object[]{k1})
        int n = list.size();

        if (key > 0) { // 通过Parameter Changes的控制流,判断Parameter是正数还是负数
            if (flag == null) { // 真
                if (n <= 0) {
                    return result;
                }
                n = parse(new Object[]{(String) list.get(list.size() - 1)});
            }
        }

        if (flag == null) {// 真
            if (n == 0) {
                n = this.l();
                if (flag == null) { // 真
                    if (n == 0) {
                        result *= 0.1;
                        return result;
                    }
                    n = list.size();
                }
            } else {
                n = list.size();
            }
        }

        if (n <= 1) {
            return result;
        }

        double t = result * 0.25;
        if (key < 0) { // 假
            return t;
        }
        result = t;

        if (flag != null) { // 假
            result *= 0.1;
        }
        return result;
    } catch (x1 e) {
        throw nnn.a("i", e, -2926417976333327871L, key);
    }
}
实际上很简单不是吗,只需要能得到Parameter+这个 Invoke Dynamic 的值,就可以很轻松的区分条件摘除虚假逻辑。
不透明谓词
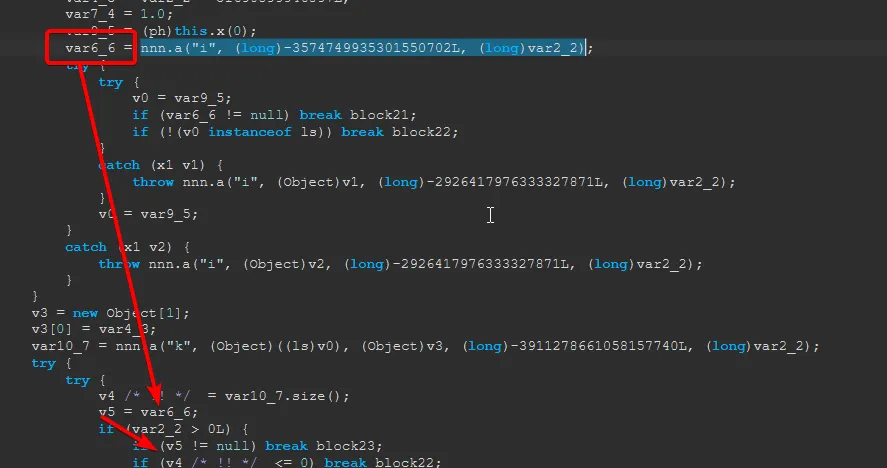
不透明谓词假跳
实际上一个不透明谓词的方法非常简单,一般是返回一个int或者boolean或者String,然后有一个setter,这个setter会在不透明谓词类的static块里初始化。
令人蒙古的是这个setter也会生成引用,但是根据笔者的观察,生成出来的引用都是在无法到达的地方,给人不透明谓词字段会变的错觉。实际上他根本不会变,直接得到的就是最终值,这是笔者分析了诸多样本之后得出的结论。
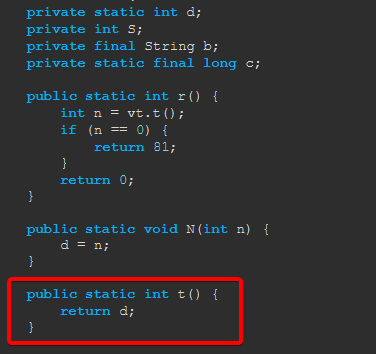
假跳形式
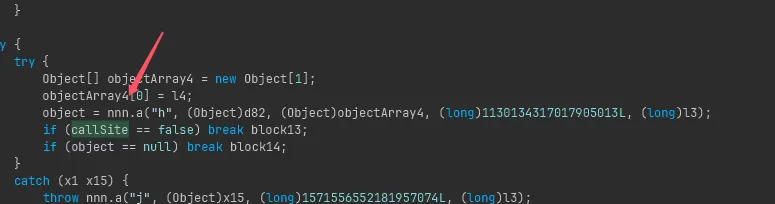
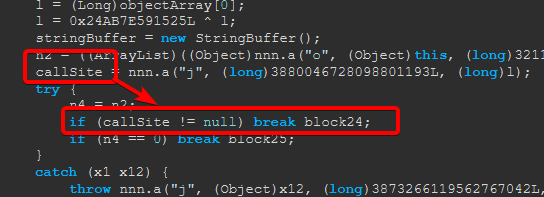
总体来说ZKM的控制流假跳形式分为三种,都有明显的特征,移除对应的指令即可清理。
这些条件也有可能随机取反变成真跳,所以必须求值这些条件才能完美清理,不能只靠下方是否有跳转来决定。
int/boolean判断假跳
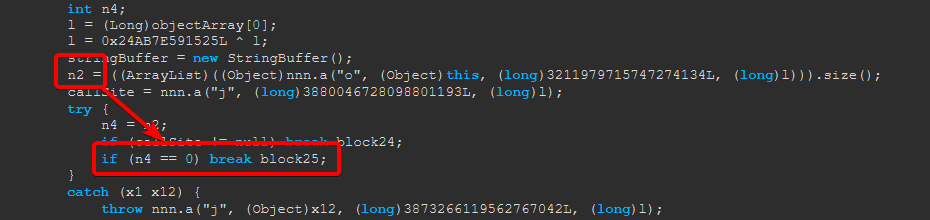
Object 判断 ifnull/ifnonnull 假跳
方法参数 long key 正负假跳
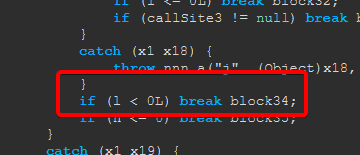
这一种通常会和Parameter Changes联动,如果你不能求值所有Parameter就无法正确清除
异常混淆(Exception Obfuscation)
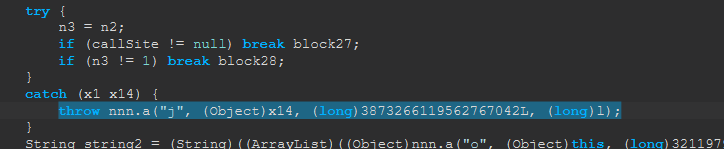
ZKM 会在代码中插入大量 try catch 块然后 throw 的是一个Invoke Dynamic,但是实际上他指向的方法是一个非常无意义的东西:
// 对就长这样
private static Exception a(Exception exception) {
    return exception;
}
如果有这种东西,说明这个 try catch 块是 ZKM 插入的垃圾,可以直接删除。
细节
除了反混淆之外,ZKM中的一些细节也非常值得考究。
暗桩
ZKM中有很多暗桩,防止你篡改或破解。
授权信息篡改检测
在ZKM运行之后会输出日志,然后日志里会包含你的授权信息。
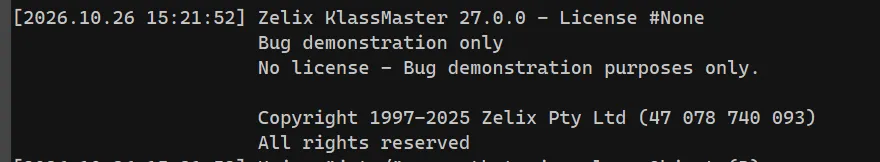
Log文件里的授权信息示例
在运行之后他会读回去日志,检测这个授权信息的Hash是否与一个预先生成的Hash(应该是ZKM编译时自动注入的)一致,如果不一致就会触发暗桩。
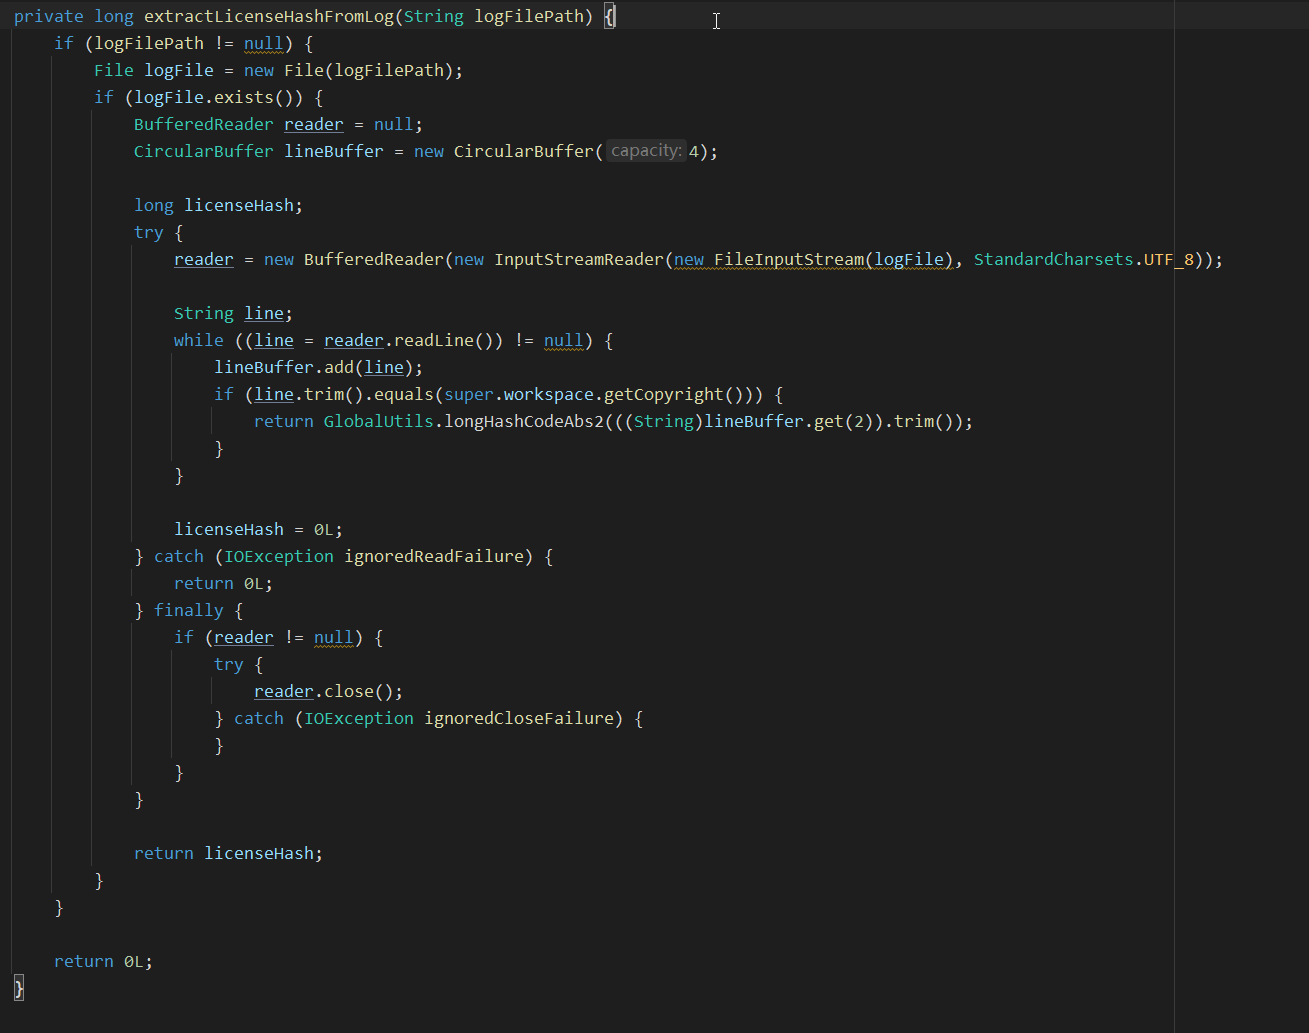
ZKM读取日志的代码
暗桩触发之后会在错误的地方插入Label和GOTO,导致混淆出错,混淆出来的产物将无法运行
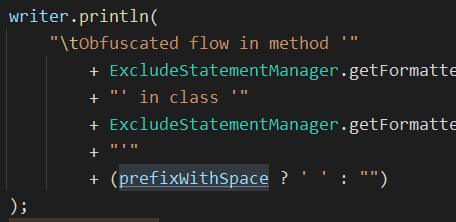
prefixWithSpace = !licenseVerified;
令人蒙古的是如果这个暗桩被触发,他会在某一行日志前面加一个空格。笔者认为这是为了如果你拿着因为触发暗桩导致的错误日志去反馈工作人员可以识别,这是因为修改了License信息而崩溃的。
时间同步检测
如果你通过重定向currentTimeMillis破解试用版或者某些特殊授权的过期时间检测他可以检测到,因为他会读取日志文件的修改时间戳来判断时间是否被篡改。
当然这个方案并不能防止修改系统时间,可以防止只让ZKM获取错误的时间。
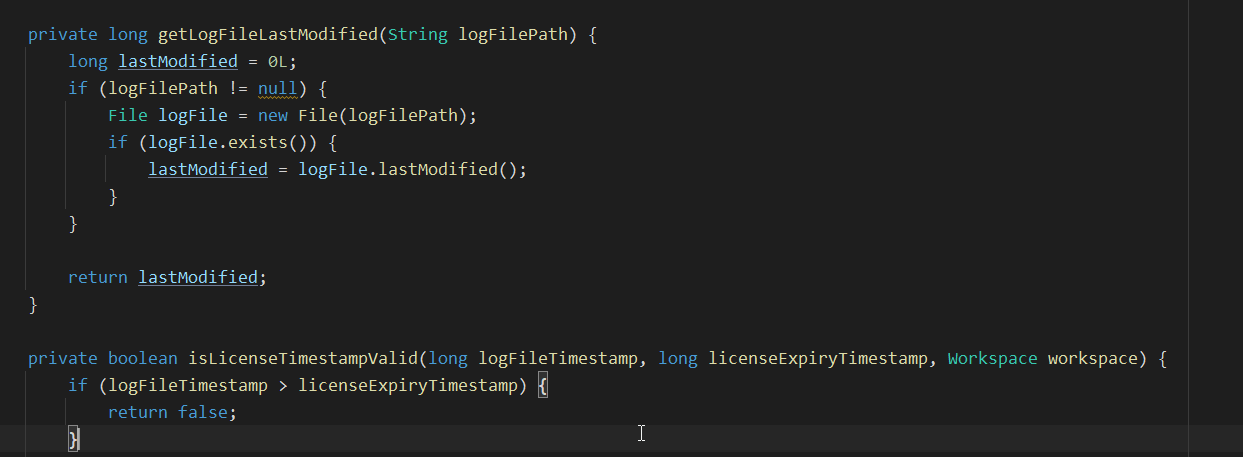
混淆时检测
除了启动时检测还有混淆时检测,也是一套完整的检测
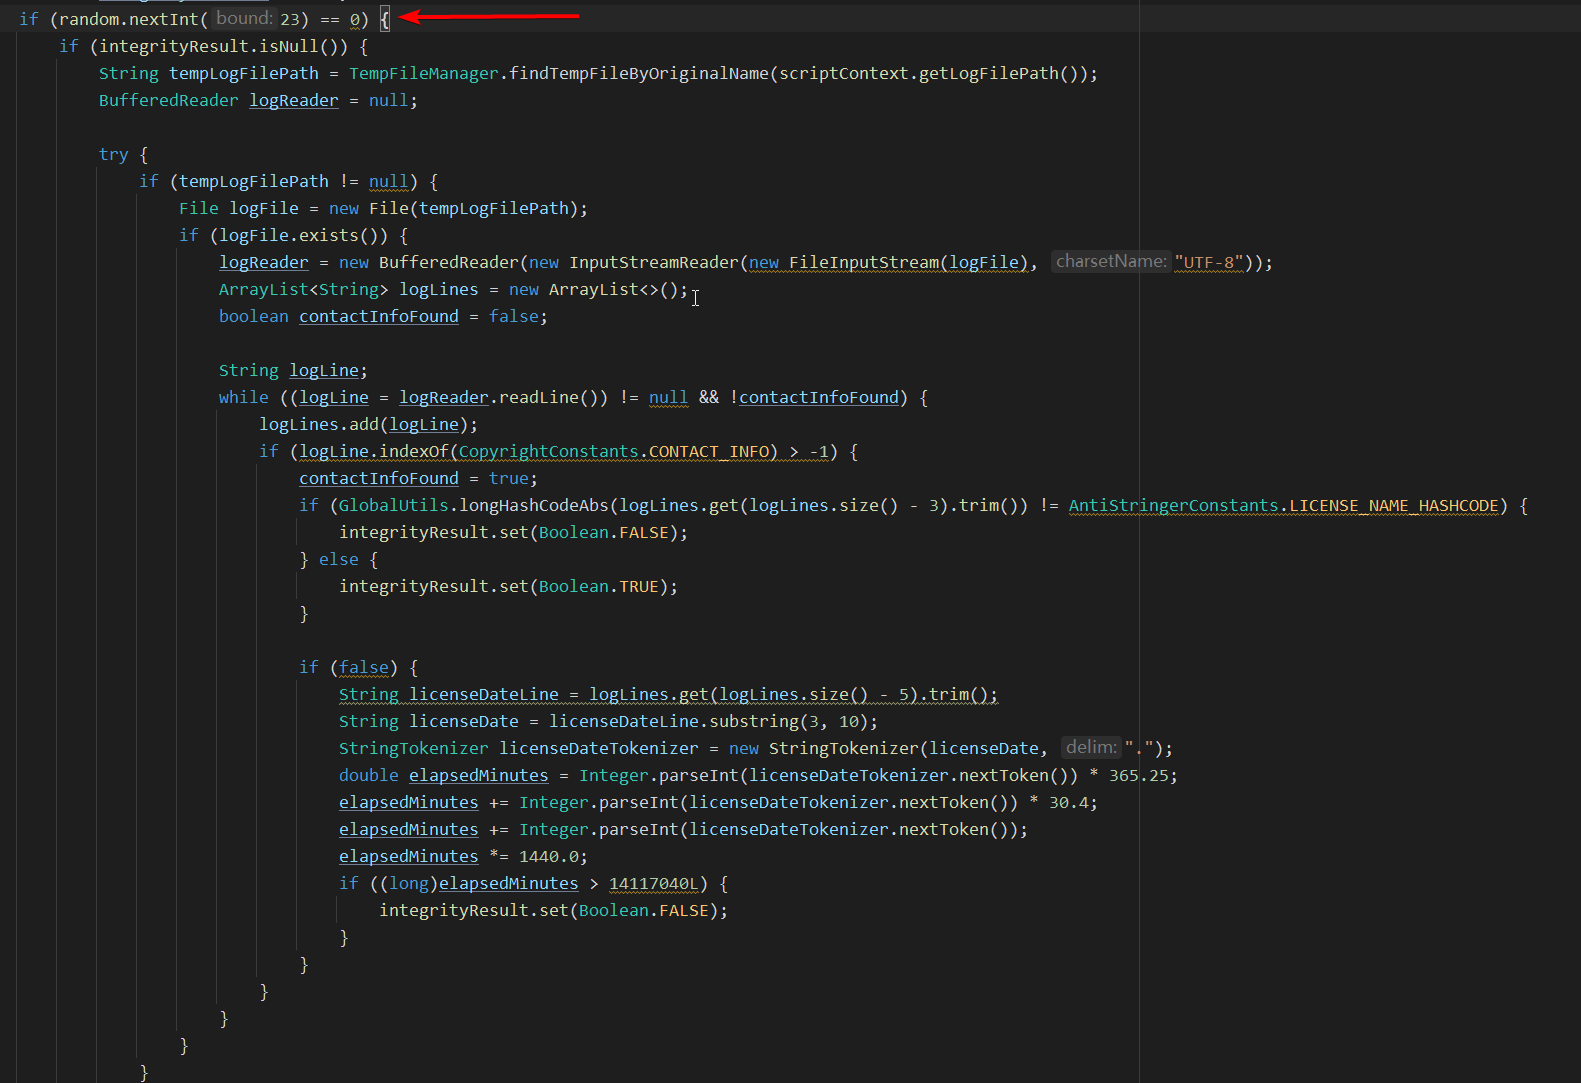
那个if(false)内为试用版独有逻辑
检测并非每次都触发,每次混淆开始时会random.nextInt(23),如果结果是0才会触发,会让你更难去探测自己有没有修复。
这个检测触发之后将不会建立继承关系表,混淆之后的文件继承关系将不会处理,所有继承命名都会不一致导致无法正常使用。
水印
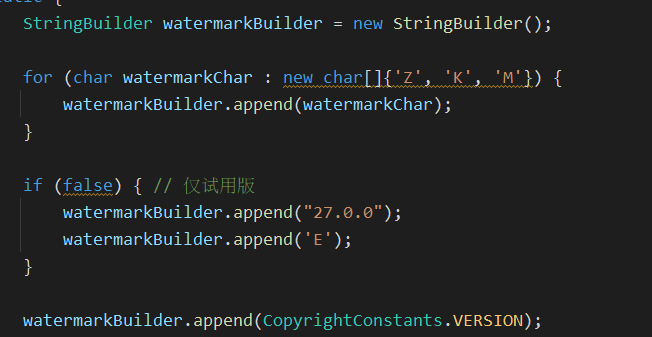
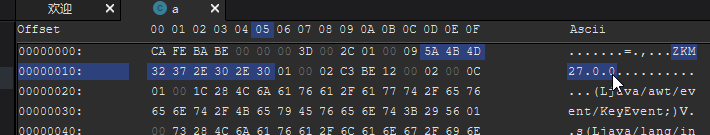
ZKM会将自身版本号写入到输出的Class的常量池,如果是试用版,还会有E标记。
AutoReflection™ 是怎么实现的
ZKM 的 Name Obfuscation(或者叫Renamer)可以几乎完美的处理反射,包括各种字符串拼装。
其原理是创建了一个原名SHA512->混淆名的映射表,然后代理了所有反射方法,传入原名之后进行哈希,如果能查到混淆名就自动重定向过去返回Field或者Method。
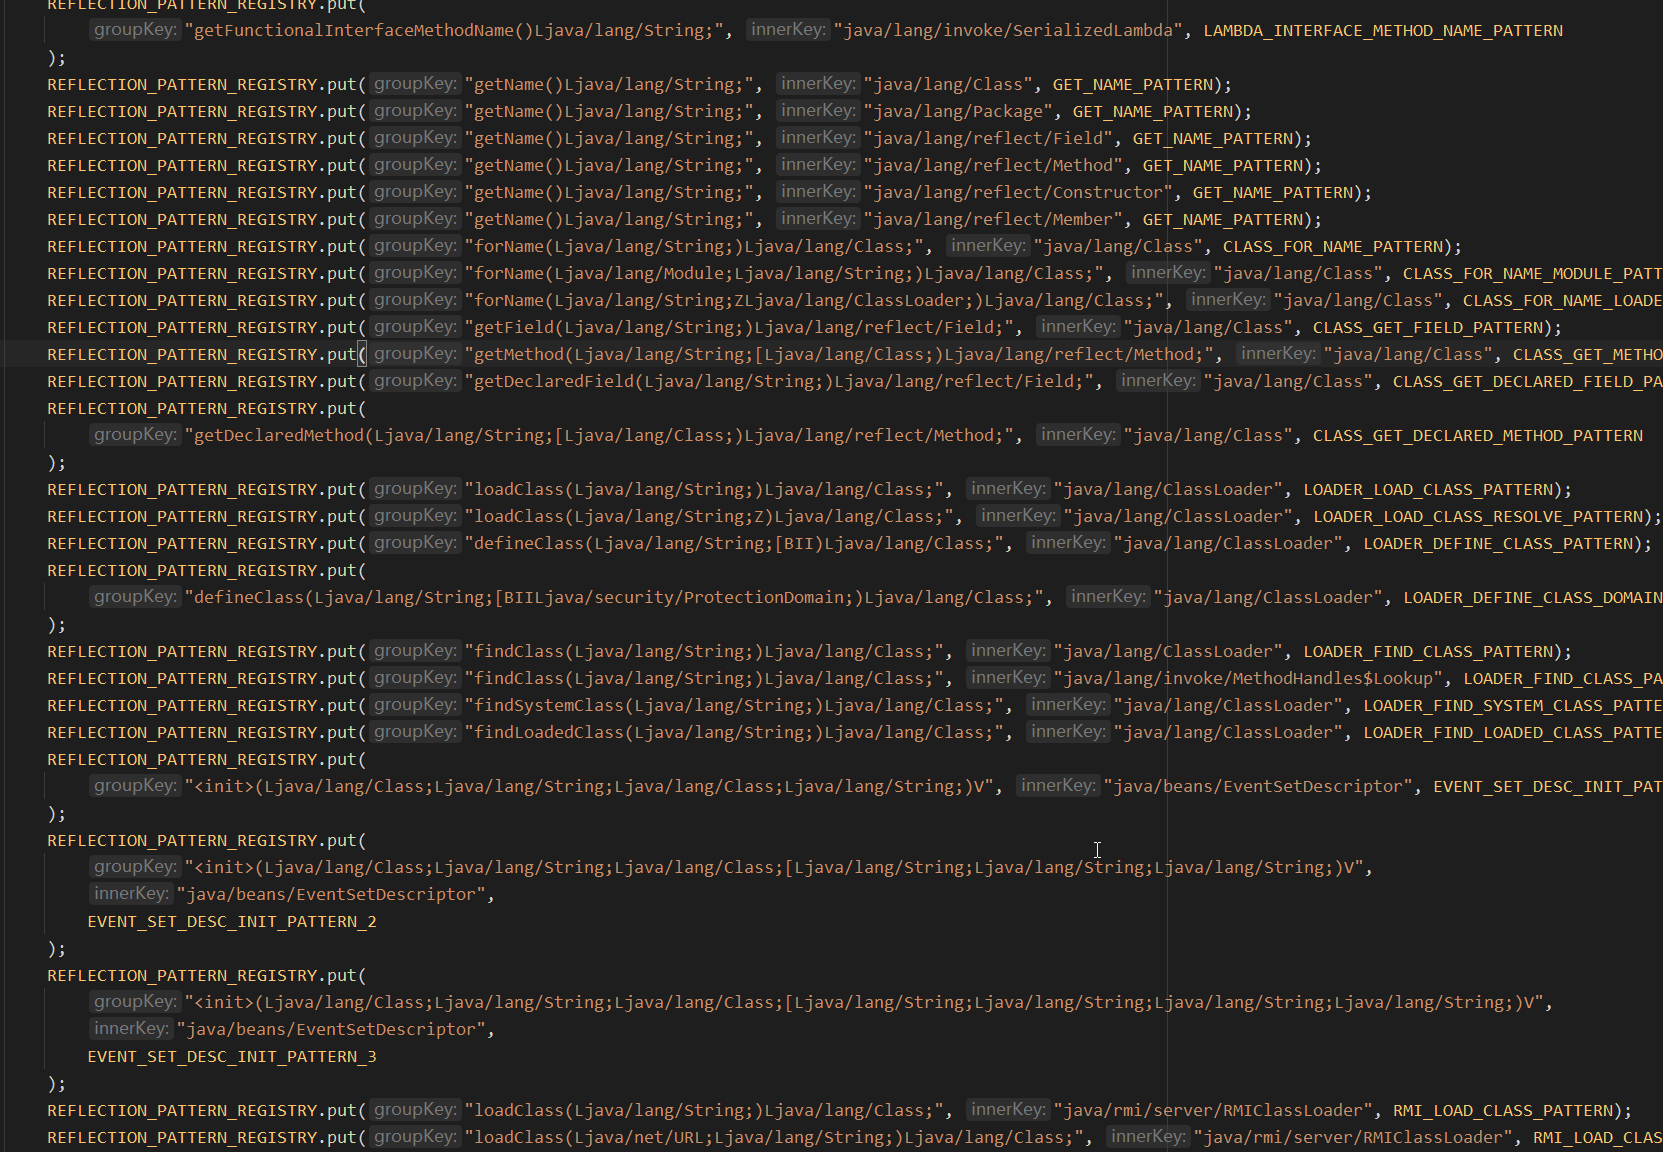
当然这一套机制ZKM自身也有很多地方在用,他给所有com.zelix.klassmaster.KlassMaster这个字符串通过密钥是java/lang/Object的XOR加密,然后通过Auto Reflection的Wrapper来访问,所以ZKM内部也有很多反射访问,开发者可以毫无压力的使用反射,Auto Reflection会处理好。
同时由于只储存的原名的SHA512,你无法通过Auto Reflection推测全部原始命名。
鸣谢
- Zelix Pty Ltd: 创建了 Zelix Klass Master
- DeobfuscatorBase:反混淆基础设施
- java-deobfuscator: 对旧版本ZKM(5.0-8.0)的研究,为我们提供了很多思路
- ZHYUjun: 制作了很酷的宣传视频
免责声明
本文为笔者对 2025 年对 ZKM 的逆向的复盘,现在是溜溜梅时代当然有更优雅的解法,所以这些内容仅供参考,不要忘了当时最强的溜溜梅是Claude Opus 4.0。
本文由 cubk、EscapistKid、Inkarro、mckuhei 共同完成。经团队全体成员一致同意,授权共创作者 Inkarro 将本文同步发布至看雪论坛(看雪ID:Inkarro,帖子链接:链接)
订阅更新
如果您喜欢我的文章,输入您的邮箱订阅更新,有新的文章会通知您
登录 GitHub 后参与讨论
加载评论中…